




Puntos clave: La interpretabilidad y la explicabilidad son fundamentales para entender los modelos de aprendizaje automático. La interpretabilidad se relaciona con las relaciones causales, mientras que la explicabilidad aclara la importancia de los parámetros, tanto esenciales para generar confianza como para construir una IA ética.
- Una alta interpretabilidad está vital en situaciones de alto riesgo para la rendición de cuentas.
- La explicabilidad ayuda a Reduce los sesgos en los procesos automáticos de toma de decisiones.
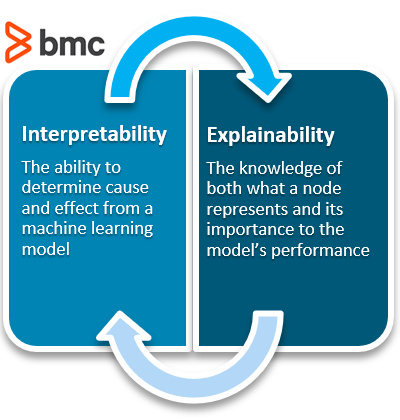
La interpretabilidad tiene que ver con lo precisa que un modelo de aprendizaje automático puede asociar una causa a un efecto. La explicabilidad tiene que ver con la capacidad de los parámetros, a menudo ocultos en redes profundas, para justificar los resultados.
Este están un artículo largo. Aguanta y, al final, te entenderás:
- Cómo la interpretabilidad está diferente de la explicabilidad
- Por qué un modelo podría necesitar ser interpretable y/o explicable
- Quién está trabajando para resolver el problema de la caja negra y cómo
¿Qué es la interpretabilidad?
¿Chipotle te Haz el estómago? ¿El ruido fuerte acelera la pérdida auditiva? Son las mujeres menos agresivas que los hombres? Si un modelo de aprendizaje automático puede Crea una definición alrededor de estas relaciones, están interpretables.
Todos los modelos deben Comienza con una hipótesis. La curiosidad humana impulsa a un ser a intuir que una cosa se relaciona con otra. "Hmm... varias personas negras disparadas por policías... aparentemente desproporcionadas respecto a otras razas... ¿algo podría ser sistémico?" Explora.
Las personas Crean modelos internos para interpretar su entorno. En el campo del aprendizaje automático, estos modelos pueden probarse y verificarse como representaciones precisas o inexactas del mundo.
La interpretabilidad significa que se puede determinar la causa y el efecto.
Si un modelo puede tomar las entradas y Obtén rutinariamente las mismas salidas, el modelo está interpretable:
- Si te comes de más la pasta a la hora de cenar y siempre te problemas para dormir, la situación están interpretable.
- Si todas las encuestas de 2016 mostraron una victoria demócrata y el candidato republicano asumió el cargo, todos esos modelos mostraron baja interpretabilidad. Si el objetivo de los encuestadores es tener un buen modelo, que la institución periodística está obligada a hacer —informar de la verdad— entonces el error muestra que sus modelos necesitan actualizarse.
Baja interpretabilidad
La interpretabilidad no supone problema en escenarios de bajo riesgo. Si un modelo están recomendar películas para ver, eso puede ser una tarea de bajo riesgo. (A menos que te seas uno de los grandes proveedores de contenido, y todas tus recomendaciones sean tan malas que la gente sienta que está perdiendo el tiempo, pero te Obtén el panorama). Si un modelo están generar qué color será tu favorito del día o generar objetivos yoguis simples en los que te se centren durante el día, juegan juegos de bajo riesgo y la interpretabilidad del modelo están innecesaria.
La necesidad de una alta interpretabilidad
A veces la interpretabilidad debe ser alta para justificar por qué un modelo están mejor que otro.
En Moneyball, los ojeadores de la vieja escuela tenían un modelo interpretable que usaban para elegir buenos jugadores para los equipos de béisbol; estos no eran modelos de aprendizaje automático, pero los ojeadores habían desarrollado sus métodos (básicamente un algoritmo) para seleccionar qué jugador rendiría bien una temporada o otra. Pero el entrenador principal quería cambiar este método.
Para que los métodos de Billy Beane funcionaran, y para que la metodología se popularizara, su modelo tenía que ser altamente interpretable cuando iba en contra de todo lo que la industria creía que era cierto. La interpretabilidad de modelos altos gana los debates.
Riesgo y responsabilidad
Un modelo con alta interpretabilidad está deseable en un juego de alto riesgo y riesgo. Modelos de alta interpretabilidad equivalen a poder responsabilizar a otra parte. Y cuando son modelos predicen si una persona tiene cáncer, las personas deben ser responsables de la decisión tomada. Los modelos altamente interpretables y mantener una alta interpretabilidad como estándar de diseño pueden ayudar a generar confianza entre ingenieros y usuarios.
Ya es bastante malo cuando la cadena de mando impide que una persona pueda hablar con la parte responsable de tomar la decisión. Está mucho peor cuando no está ninguna parte responsable y están un modelo de aprendizaje automático al que todos le atribuyen la responsabilidad. No está retribuición en imponer una penalización al modelo por sus acciones.
Cuando Theranos no lograba obtener resultados precisos con una "sola gota de sangre", la gente podía dejar de apoyar a la empresa y ver cómo ella y sus líderes fraudulentos quebraban.
Por último, una alta interpretabilidad permite a la gente jugar con el sistema. Si el profesor reparte una rúbrica que muestra cómo son corrigiendo el examen, todo lo que el alumno tiene que hacer están jugar sus respuestas al examen. Si el profesor están un fanático de Wayne's World, el alumno sabe que debe contar anécdotas a Wayne's World. O, si el profesor realmente quiere Haz seguro de que el alumno entiende el proceso de descomposición de las bacterias en el estómago, entonces no debería describir los tipos de proteínas y bacterias que existen. En su lugar, debería ir directamente al grano de lo que están haciendo la bacteria.
Los estudiantes descubrieron que el sistema automático de calificación o el SAT no podían comprender realmente lo que se escribía en sus exámenes. De alguna manera, los estudiantes accedían a la información de un modelo altamente interpretable. Los clasificadores de aprendizaje automático de los Robo-Graders obtenían una puntuación más alta en palabras más largas que en palabras cortas; era así de simple. Una cadena de palabras de 10 dólares podía obtener una puntuación superior a una oración completa con palabras de 5 céntimos y un tema y predicado.
Como informó VICE, "'El generador BABEL demostró te puede tener total incoherencia, es decir, una frase no tiene nada que ver con otra', y aun así recibir una nota alta de los algoritmos." Por supuesto, los estudiantes se aprovecharon.
Habiendo trabajado yo mismo en el campo del PLN, estos casos no están exentos de fallos, pero la gente son creando formas para que el algoritmo sepa cuándo un texto están solo un galimatías o si están algo al menos moderadamente coherente.
¿Qué es la explicabilidad?
Los modelos de aprendizaje automático son a menudo llamados modelos caja negra porque permiten asignar valores a un número preestablecido de parámetros vacíos, o nodos, por parte del algoritmo de aprendizaje automático. Específicamente, el paso de retropropagación es responsable de actualizar los pesos basándose en su función de error.
Para predecir cuándo podría morir una persona —la divertida apuesta que uno podría hacer al calcular una prima de seguro de vida, y la extraña apuesta que una persona hace contra su propia vida al comprar un paquete de seguro de vida— un modelo absorbe sus entradas y genera un porcentaje de probabilidad que la persona tenga de vivir hasta los 80 años.
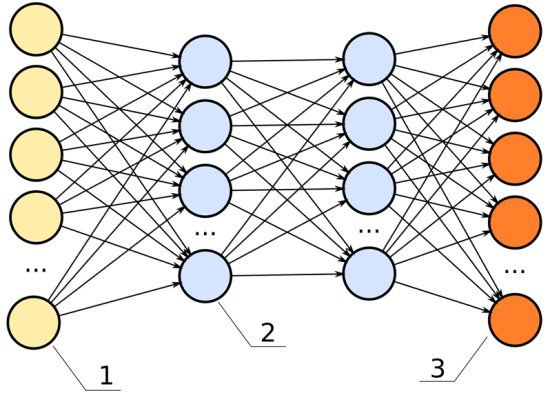
Debajo está una imagen de una red neuronal. Las entradas son amarillas; las salidas son las naranjas. Como una rúbrica para una nota global, la explicabilidad muestra cuán significativa contribuye cada parámetro, todos los nodos azules, a la decisión final.
Por ejemplo, tenemos estas entradas de datos:
- Edad
- Puntuación IMC
- Número de años que pasó fumando
- Categoría de carrera
Si este modelo tuviera alta explicabilidad, podríamos decir, por ejemplo:
- La categoría profesional está aproximadamente un 40% importante
- El número de años que se pasa fumando es un 35% importante
- La edad está en un 15% de importancia
- La puntuación del IMC está un 10% importante
Explicabilidad: importante, no siempre necesaria
La explicabilidad se vuelve significativa en el campo del aprendizaje automático porque, a menudo, no está evidente. La explicabilidad a menudo está innecesaria. Un ingeniero de aprendizaje automático puede construir un modelo sin haber considerado nunca su explicabilidad. Están un paso extra en el proceso de construcción, como llevar el cinturón de seguridad al conducir un coche. No están necesario que el coche funcione, pero ofrece seguro cuando las cosas chocan.
El beneficio que ofrece una red neuronal profunda a los ingenieros están crea una caja negra de parámetros, como puntos de datos adicionales falsos, que permiten a un modelo basar sus decisiones. Estos puntos de datos falsos van Unknown al ingeniero. La caja negra, o capas ocultas, permite que un modelo Haz asociaciones entre los puntos de datos dados para predecir mejores resultados. Por ejemplo, si son decidir cuánto tiempo puede tener alguien de vida, y utiliza datos de carrera como entrada, están posible que el modelo ordene las carreras en opciones de alto y bajo riesgo por sí solo.
Quizá inspeccionemos un nodo y Ve que relaciona entre sí a trabajadores de plataformas petrolíferas, soldadores submarinos y cocineros de barcos. Están posible que la red neuronal establezca conexiones entre la vida útil de estos individuos y ponga un marcador en la red profunda para asociarlos. Si examináramos los nodos individuales en la caja negra, podríamos notar que este agrupamiento interpreta las carreras en el agua como un trabajo de alto riesgo.
En el gráfico anterior, cada una de las líneas que conectan desde el punto amarillo hasta el azul puede representar una señal, valorando la importancia de ese nodo para determinar la puntuación global de la salida.
- Si esa señal está alta, ese nodo está significativo para el rendimiento global del modelo.
- Si esa señal está baja, el nodo está insignificante.
Con esta comprensión, podemos Define la explicabilidad como:
Conocimiento de lo que representa un nodo y de lo importante que es para el rendimiento del modelo.
¿Cuestionando el "cómo"?
Las tareas de clasificación de imágenes son interesantes porque, normalmente, los únicos datos proporcionados están una secuencia de píxeles y etiquetas de los datos de la imagen. El propósito general de usar datos de imagen están Detecta qué objetos son en la imagen. Si te introducir una imagen de un perro, entonces la salida debería ser "perro". Cómo ocurre esto puede ser completamente Unknown y, mientras el modelo funcione (alta interpretabilidad), a menudo no están duda de cómo.
En los algoritmos de detección de imágenes, normalmente Redes Neuronales Convolucionales, sus primeras capas contendrán referencias a sombreado y detección de bordes. El humano nunca tuvo que Define explícitamente un borde o una sombra, pero como ambos son comunes en todas las fotos, las características se agrupan como un solo nodo y el algoritmo clasifica el nodo como significativo para predecir el resultado final. El modelo de detección de imágenes se vuelve más explicable.
Google se disculpó recientemente por los resultados de su modelo. Como le gusta decir el titular, su algoritmo produjo resultados racistas. Los modelos de aprendizaje automático no se son usados generalmente para Haz una sola decisión. Se crean, al igual que el software y los ordenadores, para Haz muchas decisiones una y otra y otra vez. Los modelos de aprendizaje automático son diseñados para Haz decisiones a gran escala. Si esas decisiones contienen sesgos hacia una raza o un sexo, e influyen en el comportamiento de esos grupos, entonces pueden errar de forma muy grave.
El equivalente sería decirle a un niño que puede tener los caramelos mientras que al otro que no puede. La decisión condicionará al niño a Haz decisiones de comportamiento sin caramelos. Con el aprendizaje automático, esto ocurre a gran escala y con todos. Y—un punto crucial—la mayoría de las veces, las personas que son afectadas no tienen ningún punto de referencia para Haz afirmaciones de sesgo. Simplemente saben que están pasar algo que no entienden del todo.
En apoyo de la explicabilidad
Para los entusiastas activistas, la explicabilidad están importante para que los ingenieros de ML la utilicen para asegurar que sus modelos no son tomando decisiones basadas en sexo, raza o cualquier otro dato que quieran Haz ambiguos. Las decisiones que Haz los modelos basándose en estos elementos pueden ser graves o erróneas de modelo a modelo.
Afortunadamente, en una sociedad libre y democrática, son personas, como los activistas y periodistas del mundo, que mantienen a las empresas bajo control e intentan señalar estos errores, como el de Google, antes de que están causados daños. En una sociedad con contratistas independientes y muchos trabajadores remotos, las corporaciones no tienen un gobierno dictatorial para construir malos modelos y aplicarlos en la práctica. Los trabajadores de muchas empresas tienen más facilidad para informar sus hallazgos a otros y, aún más importante, son capaces de corregir cualquier error que pueda escapar mientras trabajan en su rutina diaria.
Una buena comunicación y un gobierno democrático aseguran una sociedad que están autocorrectiva. Esto está persistentemente cierto en la ingeniería resiliente y la ingeniería del caos. Lo es cuando se evita la espiral de muerte corporativa. Están una razón para apoyar modelos explicables. Los modelos explicables (XAI) mejoran la comunicación en torno a las decisiones.
Explorando los componentes explicables de un modelo de aprendizaje automático y ajustándolos, es posible ajustar la predicción general. Para señalar otro tema candente en otro espectro, Google hizo aparecer una competición en Kaggle en 2019 para "acabar con el sesgo de género en la resolución de pronombres". Básicamente, los procesos del lenguaje natural (PLN) utilizan una técnica llamada resolución de copreferencias para vincular los pronombres a sus sustantivos. Se ha convertido en una tarea de aprendizaje automático predecir el pronombre "ella" después de que se están usados los términos "Shauna".
A Shauna le gusta correr. Es su deporte favorito.
La resolución de copreferencia mapeará:
- Shauna → ella
- Las carreras →
Esta técnica puede aumentar la información conocida en un conjunto de datos entre 3 y 5 veces reemplazando todas las entidades Unknown—las shes, suyas, its, suyas, thems—por la entidad real a la que se refieren— Jessica, Sam, juguetes, Bieber International. El objetivo del concurso era descubrir el mecanismo interno que explica el género y hacer ingeniería inversa para desactivarlo.
Podría pensarse que las grandes empresas no son luchando por acabar con estos problemas, pero sus ingenieros se unen activamente para considerar los asuntos. Económicamente, aumenta su buena voluntad.
Usé bastante Google en este artículo, y Google no está en una sola mente. Google es una ciudad pequeña, con unos 200.000 empleados, con casi tantos trabajadores temporales, y su influencia está incalculable. Amazon está en 900.000 empleados en una situación similar con los temporales. Eso están demasiadas personas como para que exista mucho secreto. Enron tenía 29.000 personas en su época.
Resolución del problema de la caja negra
Por último, para terminar con Google en alto, Susan Ruyu Qi elaboró un artículo con un buen argumento sobre por qué Google DeepMind podría haber solucionado el problema de la caja negra. La cuestión están: la explicabilidad está un problema central que el campo del aprendizaje automático está resolviendo activamente. Con todo el mundo enfrentándose a muchos lados del mismo problema, va a ser difícil que algo realmente malo pase desapercibido bajo las narices de alguien.
Los ordenadores siempre han atraído a los forasteros de la sociedad, las personas contra las que los grandes sistemas siempre se enfrentan. Estas personas se miran al espejo ante las anomalías cada día; son los vigilantes perfectos para pulir líneas de código que dictan quién recibe tratamiento y cómo. La explicabilidad y la interpretabilidad añaden un componente observable a los modelos de aprendizaje automático, permitiendo a los vigilantes hacer lo que ya son hacen.
También hay promesa en la nueva generación de veinteañeros que han aprendido a apreciar el valor del denunciante. Mantienen un código moral independiente que está por encima de todo. Si no tú me crees: ¿Por qué te otro motivo de pensar que saltan de trabajo en trabajo?
Recursos adicionales
Explora el blog BMC Machine Learning & Big Data y estos recursos relacionados:
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.