




Puntos clave: La escala logarítmica de Matplotlib mejora la visualización de datos al mostrar eficazmente los valores a lo largo de grandes rangos, haciendo que los números pequeños y grandes sean interpretables. Al utilizar potencias de 10, evita la compresión de valores más pequeños.
- Las escalas logarítmicas son esenciales para visualizar amplios rangos de datos.
- Ejemplos de código demuestran cómo implementar escalas logarítmicas en gráficos Matplotlib.
En este artículo, explicaremos cómo utilizar la escala logarítmica en Matplotlib.
La escala logarítmica están útil para graficar datos que incluyen números muy pequeños y muy grandes porque la escala grafica los datos para te puede Ve todos los números fácilmente, sin que los números pequeños se compriman demasiado.
Logaritmos
Primero, repasemos un poco de matemáticas de instituto. Un logaritmo están una forma de Haz que un número grande parezca pequeño viéndolo como una potencia de 10. Hay otras bases de son logaritmos además del 10, como el logaritmo natural usado en matemáticas, que está dado por la constante e=2,718.... Pero, para nuestros propósitos, utilizaríamos logaritmos en base 10.
En resumen:
log10x = y significa que 10 elevado a potencia y es igual a x, es decir, 10 ** y = x. Así que log10100=2 porque 10**2 = 100.
La escala logarítmica en Matplotlib
Un gráfico bidimensional en Matplotlib tiene una escala y y una escala x. La escala significa las graduaciones o marcas de verificación a lo largo de un eje. Pueden ser cualquiera de:
- matplotlib.scale.LinearScale—Estos son solo números, como 1, 2, 3.
- matplotlib.scale.logScale—Estas son potencias de 10. te podrían utiliza cualquier base, como 2 o el valor del logaritmo natural, que están dado por el número e. Usar bases diferentes estrecharía o ensancharía el espaciado de los elementos trazados, facilitando la visibilidad.
- matplotlib.scale.SymmetricalLogScale y matplotlib.LogitScale—Estos se son usados para números menores que 1, en particular para números muy pequeños cuyos logaritmos son números negativos muy grandes.
Uso de la escala logarítmica
Vamos a graficar los ingresos de algunas grandes empresas y de otras pequeñas.
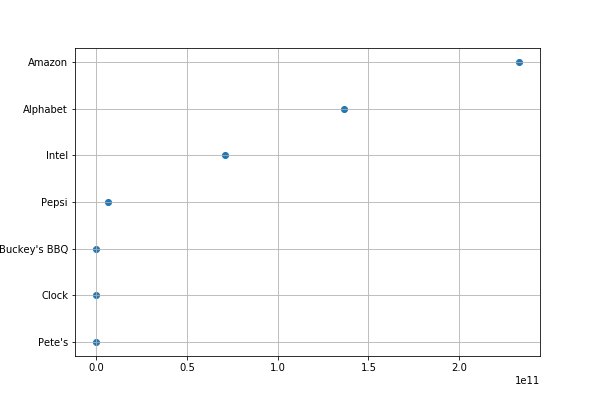
Amazon, Alphabet (Google) e Intel son muchas veces más grandes que las pequeñas empresas Pete's, Clock y Buckey's BBQ (que nosotros inventamos). La diferencia entre ellas y Amazon es enorme, así que el gráfico de cada empresa pequeña se encuentra en la misma línea vertical 0 en la escala lineal.
Matplotlib elige la escala para los ejes si te no la fija explícitamente. Aquí no lo hicimos. La pequeña notación le11 al final significa que el xaxis están en notación científica, que en este caso significa ingresos están mostrado un múltiplo de 10**11 (100.000 millones de dólares). Los ingresos de Amazon de 232.887.000.000 están 2,325*(10**11). Mientras que Pete es de 600.000 dólares, como potencia de 11, están 0,000006*(10**11). Esto explica por qué incluso Pepsi, una gran empresa, está cerca de cero en el gráfico de abajo.
Así que solucionamos ese problema en el siguiente gráfico usando la escala logarítmica. Ve abajo una explicación del código.
    import matplotlib.pyplot as plt
import numpy as np
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

data = {
        "Pete's":           600000,
        "Clock":           1600000,
        "Buckey's BBQ":    2600000,
        "Pepsi":        6466000000,
        "Intel" :      70848000000,
        "Alphabet":    136819000000,
        "Amazon":      232887000000
        }

df = pd.DataFrame.from_dict(data,orient='index',columns=['Revenue'])
dg =pd.to_numeric(df['Revenue'])
dc = pd.Series(dg.index.values.tolist()).to_frame('Company')
dat = df.assign(Company=dc.values)

data = dat.sort_values(by=['Revenue'])

plt.scatter(data['Revenue'],data['Company'])
plt.grid()
plt.show()
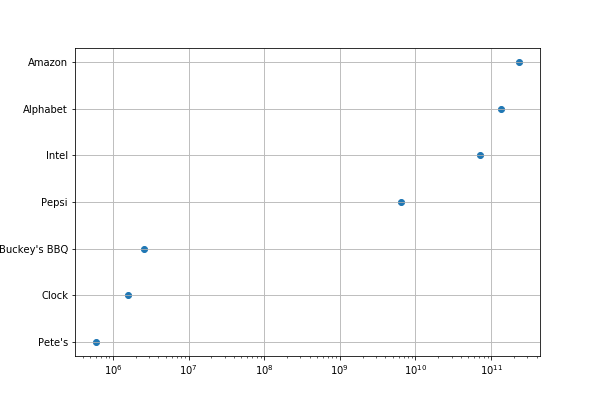
Aquí, todo está igual excepto que incluimos plt.xscale("log"). Ahora podemos Ve los valores más fácilmente ya que son potencias de 10. Así que, los pequeños ingresos de Pete, 600.000 dólares, están fáciles de Ve porque son 6*(10**6). Y los de Amazon están aproximadamente 100.000 (10**5) veces mayores.
    import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

data = {
        "Pete's":           600000,
        "Clock":           1600000,
        "Buckey's BBQ":    2600000,
        "Pepsi":        6466000000,
        "Intel" :      70848000000,
        "Alphabet":    136819000000,
        "Amazon":      232887000000
        }

df = pd.DataFrame.from_dict(data,orient='index',columns=['Revenue'])
dg =pd.to_numeric(df['Revenue'])
dc = pd.Series(dg.index.values.tolist()).to_frame('Company')
dat = df.assign(Company=dc.values)

data = dat.sort_values(by=['Revenue'])

plt.scatter(data['Revenue'],data['Company'])
plt.grid()
plt.xscale("log")
plt.show()
Ahora te puedes Ve con más claridad el tamaño de cada empresa por sus ingresos
Explicación del código
Parte de este código puede ser difícil de entender sin un conocimiento de ciencia de datos porque utiliza Pandas y NumPy. Esto es irónico, ya que Pandas fue creado especialmente para Haz el trabajo con datos tipo tabla.
El primer paso toma los datos que hemos creado como diccionario y los convierte en un dataframe de Pandas. El índice de estos datos será el nombre de la empresa. Dijimos orient='index' , es decir, toma la primera entrada como valor del índice. Luego le damos un nombre de columna con columnas=['Ingresos']. El nombre de la empresa no tiene nombre de columna porque no es una columna; es un índice de filas.
df = pd.DataFrame.from_dict(data,orient='index',columns=['Revenue'])
A continuación, debemos convertir las cadenas de ingresos a números. De lo contrario, se ordenarán por matplotlib como letras.
dg =pd.to_numeric(df['Revenue'])
Ahora queremos Crea una serie, que están un dataframe con una sola columna. Los valores serán el índice del dataframe anterior. Así es como Obtén las empresas listadas como una columna de datos, llamada Company.
dc = pd.Series(dg.index.values.tolist()).to_frame('Company')
A continuación, añadimos los valores de la serie que acabamos de crear como otra columna en el dataframe dat .
dat = df.assign(Company=dc.values)
Luego trazamos el diagrama de dispersión dándole dataframes para los valores x e y. Cada uno tiene la misma forma, (7,), que te puede comprobar con data['Revenue'].shape. La forma están un concepto a veces difícil de NumPy. Básicamente significa la dimensión del array. En un gráfico xy deben ser iguales.
plt.scatter(data['Revenue'],data['Company'])
El resto está autoexplicativo:
    plt.grid()
plt.xscale("log")
plt.show()
Guía de visualización de datos
- La guía para principiantes en visualización de datos
- Introducción a las bases de datos de grafos
- Utiliza casos para bases de datos de grafos
- Introducción a la base de datos de grafos Neo4j
- Consultas a la base de datos de grafos Neo4j
- Explicación de los diagramas de dispersión y líneas de Matplotlib
- Cómo añadir subtramas en Matplotlib
- Escala logarítmica de Matplotlib
- Uso de Matplotlib para dibujar gráficos y diagramas
- Cómo dibujar gráficos 3D con Matplotlib
- Plotly Python Tutorial
- Habilitando a los científicos de datos ciudadanos
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.