




Puntos clave: Apache Spark permite el procesamiento en tiempo real de datos en streaming usando DStreams, transformando entradas continuas en RDDs normales. Esta guía ilustra cómo leer los precios de las acciones a través de Python y Scala, destacando las diferencias entre datos por lotes y datos en streaming.
- El streaming de datos permite un procesamiento inmediato de entradas no acotadas.
- Ejemplos incluyen el uso de la API de Yahoo Finance para recuperar el precio de las acciones.
En las dos últimas publicaciones que escribimos, explicamos cómo leer datos que fluyen desde Twitter hacia Apache Spark a través de Kafka. Aquí vemos un ejemplo más sencillo de leer un archivo de texto en Spark como un flujo.
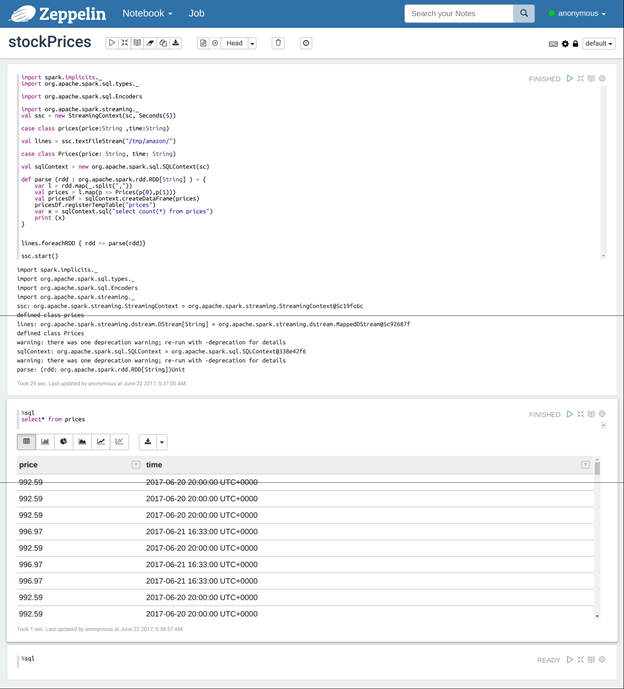
Haz un ticker bursátil sencillo que se parece a la pantalla de abajo cuando ejecutamos el código en Zeppelin.
Trabajar con datos en streaming está bastante diferente a trabajar con datos en lote. Spark Streaming lee datos en streaming en un objeto llamado DStreams. A partir de estos crea periódicamente RDDs normales.
Así que está como trabajar con RDDs, con la diferencia importante de que la entrada no está un archivo de tamaño fijo. En su lugar, está un flujo ilimitado, como tuits en Twitter, información diagnóstica que se transmite desde un motor de avión, precios de las acciones bajando del NASDAQ, etc.
Vamos a utilizar el ejemplo del precio de la acción para ilustrarlo. Vamos a utilizar la API de Yahoo Finance. Instala usando:
Sudo PIP instala yahoo-finance
Entonces:
mkdir /tmp/amazon/
Copia este código en python en un archivo de texto yahoo.py y ejecutalo:
Python yahoo.py
Esto descargará el precio de la acción de Amazon y lo escribirá en un archivo cada cinco segundos.
    from yahoo_finance import Share
import time
f = open('/tmp/amazon/amzn.csv', 'w')
while True:
amzn=Share("AMZN")
s = amzn.get_price() + "," + amzn.get_trade_datetime() + '\n'
print (s)
f.write (s)
f.flush()
time.sleep(5)
del amzn
A continuación están todo el programa Scala que utiliza procesar estos datos como un flujo. Solo están un ejemplo sencillo. te son más probable que procese datos en streaming escribiéndolos primero en Kafka, como hicimos con el ejemplo de Twitter. Pero este ejemplo sencillo te ayudará a entender cómo trabajar con datos en streaming.
Spark Streaming en realidad no maneja muy bien los archivos de texto, como veremos. A continuación explicamos que no están capaz de llevar el control de los cambios en un archivo de texto. Así que tenemos que copiar estos archivos a una carpeta nueva para que Spark detecte los cambios. Eso no están muy práctico para una aplicación de streaming. Pero, de nuevo, esto están solo un ejemplo didático. te son más probable que utiliza Kafka o lea un socket de datos que procesar un archivo de texto. Dicho esto, este código sería adecuado para una situación en la que una aplicación acumula archivos de registro, como un servidor web o un servidor LDAP. Porque allí cierra periódicamente el archivo abierto y crea uno nuevo.
Habiendo iniciado el programa en Python anterior, ejecuta spark-shell y sube todo el código de abajo al intérprete de línea de comandos de Spark. te Ve que tardará unos minutos en Comienza funcione. Luego tomará el control de la pantalla y Comienza salida que se repite.
Aquí dividimos el código en secciones para explicar las partes clave.
Código Scala
Los comandos clave aquí son new StreamingContext y ssc.textFileStream.
El primero toma el SparkContext (llamado sc, cuando se usa spark-shell) y crea un StreamingContext. Están la misma idea que SparkContext, excepto que está para transmitir datos.
ssc.textFileStream mira dentro de la carpeta indicada y lee esos datos en DStreams sin tener en cuenta ningún tipo de formato. Así que simplemente están leyendo bytes de información sobre los que aún no hemos creado ningún RDD u otras estructuras.
    import spark.implicits._
import org.apache.spark.sql.types._
import org.apache.spark.sql.Encoders
import org.apache.spark.streaming._
val ssc = new StreamingContext(sc, Seconds(5))
val lines = ssc.textFileStream("/tmp/amazon/")
El programa Python escribe el precio de la acción y el tiempo en el archivo de texto en este formato delimitado por comas:
992.59,2017-06-20 20:00:00 UTC+0000
992.59,2017-06-20 20:00:00 UTC+0000
992.59,2017-06-20 20:00:00 UTC+0000
992.59,2017-06-20 20:00:00 UTC+0000
La siguiente sección están código familiar que utiliza leer cada línea de este tipo de archivo de texto y dividir cada línea por la coma usando rdd.map. Sin embargo, no están diferencia notable están que Spark crea múltiples RDDs cuando te trabaja con datos en streaming. Por eso están hemos escrito la función parse con el tipo de parámetro org.apache.spark.rdd.RDD[String] para que lines.foreachRDD { rdd => parse(rdd)} que se muestra abajo procese cada RDD.
En otras palabras, aquí está la distinción crucial. Spark devuelve un montón de RDDs y utilizamos dstream.foreachRDD para procesar cada uno de ellos.
El resto del código crea una clase de caso para que podamos convertirla en un dataframe SQL usando sqlContext.createDataFrame.
    case class Prices(price: String, time: String)
val sqlContext = new org.apache.spark.sql.SQLContext(sc)
def parse (rdd : org.apache.spark.rdd.RDD[String] ) = {
var l = rdd.map(_.split(","))
val prices = l.map(p => Prices(p(0),p(1)))
val pricesDf = sqlContext.createDataFrame(prices)
pricesDf.registerTempTable("prices")
pricesDf.show()
var x = sqlContext.sql("select count(*) from prices")
println (x)
}
Llamamos a la función análisis para cada rdd creada, como se muestra a continuación.
lines.print() hace eco de las primeras 10 líneas del RDD en su formato bruto.
En el intérprete de línea de comandos, no ocurrirá nada hasta que ejecutemos ssc.start(). En ese momento, el programa buscará continuamente nuevos archivos añadidos a /tmp/amazon y procesará cada uno de ellos. Dejará de aceptar entradas del teclado y enviará los resultados a la pantalla.
    lines.foreachRDD { rdd => parse(rdd)}
lines.print()
ssc.start()
Cuando te ejecutes este código, espera unos segundos porque tardará un rato en arrancar.
Al principio el programa repetirá los datos que encuentra porque usamos pricesDf.show().
+------+-------------------------------+ |precio|tiempo| +------+-------------------------------+ |992.59|2017-06-20:00:...| |992.59|2017-06-20:00:...| |992.59|2017-06-20:00:...| |992.59|2017-06-20:00:...| |992.59|2017-06-20:00:...| |992.59|2017-06-20:00:...| |996.97|2017-06-21 16:33:...|
Aquí están donde las cosas se vuelven extrañas, ya que la segunda iteración mostrará un dataframe vacío. ¿Por qué están así?
+-------+-------+
|precio |tiempo|
+-------+-------+
+-------+-------+
La razón por la que el data frame están vacío, aunque el programa en Python están escribiendo datos, están entiende mejor mirando la definición en JavaDoc del textFileStream escrito por Apache Spark.
publico JavaDStream<String> textFileStream(Directorio de cadenas)
Crea un flujo de entrada que supervise un sistema de archivos compatible con Hadoop para nuevos archivos y los lea como archivos de texto (usando la clave LongWritable, el valor como Texto y el formato de entrada como TextInputFormat). Los archivos deben escribirse en el directorio monitorizado "moviéndolos" desde otra ubicación dentro del mismo sistema de archivos. Los nombres de archivo que empiezan por . son ignorados.
En otras palabras, no encontrará datos nuevos hasta que te copie manualmente un archivo nuevo a la carpeta /tmp/amazon. Eso están incómodo y están algo que te podría hacer con un script de shell. te puedes intentarlo manualmente copiando el archivo /tmp/amazon/amzn.csv a /tmp/amazon/a y luego mirando de nuevo la salida de spark-shell. te Ve que detecta los nuevos datos.
Así que te hemos dado un ejemplo de cómo trabajar con datos en streaming usando Apache Spark. A partir de aquí, te sugerimos volver atrás y revisar el ejemplo de Twitter para reforzar lo que tú has aprendido. O escribe tu propio ejemplo usando un socket TCP.
Guía Apache Spark
- La Canalización de Aprendizaje Automático de Apache Spark: Una introducción
- Ejemplo de regresión lineal SGD con Apache Spark
- Clasificador de árbol de decisión de chispa
- Uso de regresión logística, scala y chispa
- Cómo utilizar cuadernos Jupyter con Apache Spark
- Uso de aprendizaje automático en Python y Spark para hacer clasificación
- Cómo escribir UDFs (funciones definidas por el usuario) de Spark en Python
- Ejemplo de Python Spark ML K-Means
- Cómo aplicar el aprendizaje automático a la ciberseguridad
- Apache Spark: Trabajando con Streams
- K-significa agrupación con Apache Spark
- Usando Chispa con Colmena
- Cómo utilizar Apache Spark para Haz predicciones para el mantenimiento preventivo
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.