




Puntos clave: La regresión lineal usando Descenso Estocástico de Gradiente (SGD) con Apache Spark permite un modelado predictivo eficiente. Este tutorial ofrece una guía completa para implementar el modelo en Scala, cubriendo el manejo de datos, entrenamiento y cálculo de errores.
SGD está adaptado a retos analíticos específicos.
El Error Cuadrático Medio (MSE) se está utilizando para evaluar la precisión del modelo.
Conoce más sobre la Pipeline de Aprendizaje Automático de Apache Spark.
Este artículo explica cómo hacer regresión lineal con Apache Spark. Asume te tienes algún conocimiento básico de regresión lineal. Si te no los tienes, entonces te necesitas conoce porque están una de las ideas más simples en estadística. Además, la mayoría de los modelos de lenguaje máquina son una extensión de esta idea básica. están tan sencillo de entender y utiliza que te puede hacerlo con Google Sheets o Microsoft Excel. Aunque en esas herramientas te son limitada a una variable de entrada. Nuestro ejemplo aquí tiene unas 12. El objetivo están desarrollar una fórmula para Haz un modelo predictivo. Desde el instituto, te reconocerá el modelo aquí como la fórmula para una línea recta, donde b están el punto donde la línea cruza el eje y.
y = mx + b
Por ejemplo, podríamos asumir que las ventas y los gastos publicitarios son relacionados. Así que podríamos escribir:
    y = mx + b
= sales = some function of (advertising expenses ) + constant_value (b)
= (number of ads purchased (m))* (average age cost of ad ( x)) + b.
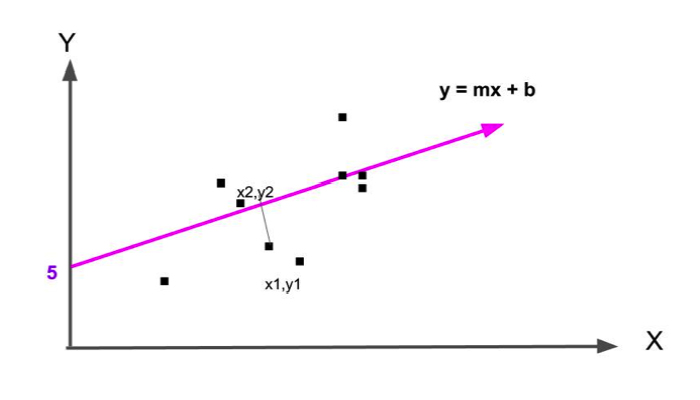
En este caso, el valor de b está 0, ya que no comprar anuncios equivale a ningún gasto. La forma clásica de resolver este problema están encontrando la línea
y = mx + b
que casi divide estos datos por la mitad, como se muestra en el gráfico de abajo. Para ello encontramos la línea cuya distancia media a los puntos de datos está menor.
La forma más sencilla de encontrar esa línea en Apache Spark están utilizando:
org.apache.spark.mllib.regression.LinearRegressionMode.
Pero un enfoque más sofisticado están utilizar:
org.apache.spark.mllib.regression.LinearRegressionWithSGD
donde significa descenso de gradiente estocástico. Por razones que van más allá del alcance de este documento, basta decir que SGD está mejor adaptado a ciertos problemas analíticos que a otros. Qué algoritmo está mejor adecuado está basado en muchos factores: como cuál hace las mejores estimaciones, la eficiencia del algoritmo, la tendencia a sobreentrenar un algoritmo (lo que lleva a deducciones sesgadas por supuestos prejuiciosos), su sensibilidad a los valores atípicos (es decir, que confunda la estimación cuando son puntos de datos están lejos de los demás), etc. La única forma de saber qué modelo utiliza están encontrar el modelo con el menor error, es decir, el modelo que produce la menor diferencia entre los valores predichos y los valores observados. Esto están lo que hacen los científicos de datos: prueban varios modelos.
Cómo programar regresión lineal con Apache Spark y Scala
Descarga estos datos: https://raw.githubusercontent.com/cloudera/spark/master/mllib/data/ridge-data/lpsa.data No importa qué datos sean esos. No son interesan los encabezados de las columnas ni siquiera saber qué significan estos datos. Solo queremos mostrar cómo hacer regresión lineal y necesitamos datos que se correlacionen. Muchos datos no se correlacionan en absoluto, lo que significa que la regresión lineal o cualquier tipo de estadística no encajará con ellos. Por ejemplo, los precios de la gasolina y las ventas de gasolina apenas son correlacionados, ya que la gente compra gasolina independientemente del precio, porque la necesita. Primero, mostramos todo el código y luego lo repasaremos línea por línea.
    import org.apache.spark.mllib.linalg.Vectors
import org.apache.spark.mllib.regression.LabeledPoint
import org.apache.spark.mllib.feature.Normalizer
import org.apache.spark.mllib.regression.LinearRegressionWithSGD
val data = sc.textFile("/home/walker/lpsa.dat")
val parsedData = data.map { line =>
val x : Array[String] = line.replace(",", " ").split(" ")
val y = x.map{ (a => a.toDouble)}
val c = Vectors.dense(y(0),y(d))
LabeledPoint(y(0), c)
val numIterations = 100
val stepSize = 0.00000001
val model = LinearRegressionWithSGD.train(parsedData, numIterations, stepSize)
val prediction = model.predict(point.features)
(point.label, prediction)
val MSE = valuesAndPreds.map{ case(v, p) => math.pow((v - p), 2) }.mean()
val parsedData = data.map { line =>
val x : Array[String] = line.replace(",", " ").split(" ")
val y = x.map{ (a => a.toDouble)}
val parsedData = data.map { line =>
val x : Array[String] = line.replace(",", " ").split(" ")
val y = x.map{ (a => a.toDouble)}
val d = y.size - 1
val c = Vectors.dense(y(0),y(d))
LabeledPoint(y(0), c)
}.cache()
val numIterations = 100 val stepSize = 0.00000001
val model = LinearRegressionWithSGD.train(parsedData, numIterations, stepSize)
-0.4307829,-1.63735562648104 -2.00621178480549 -1.86242597251066 -1.02470580167082 -0.522940888712441 -0.863171185425945 -1.04215728919298 -0.864466507337306
Eso crea datos como una RDD[String].
val data = sc.textFile("/home/walker/lpsa.dat")
Una cadena están un objeto iterable, así que la pasamos dos bucles para dividirla por espacios. Lo hacemos dos veces porque te ve en los datos que los dos primeros elementos son separados por una coma, así que primero tenemos que Obtén eso.
val parsedData = data.map { line =>
val x : Array[String] = line.replace(",", " ").split(" ")
Luego convertimos todas estas cadenas en dobles, ya que el aprendizaje automático requiere números y este algoritmo en particular requiere un vector de dobles.
val y = x.map{ (a => a.toDouble)}
El LabeledPoint está un objeto requerido por el algoritmo de regresión lineal. Está en este formato
(labels, features)
Donde las características están un vector. Aquí utilizamos un vector denso que está un tipo que no maneja valores en blanco, de los cuales no tenemos ninguno.
val parsedData = data.map { line =>
val x : Array[String] = line.replace(",", " ").split(" ")
val y = x.map{ (a => a.toDouble)}
val d = y.size - 1
val c = Vectors.dense(y(0),y(d))
LabeledPoint(y(0), c)
}.cache()
Ten en cuenta que utilizamos la palabra caché porque Spark está un sistema distribuido. Para calcular esto necesitamos recuperar datos de cada nodo. La caché, al igual que la recopilación, reúne todos los elementos de los nodos.
Entrenamiento con datos de prueba
En este ejemplo, también utiliza el conjunto de entrenamiento como los datos de prueba. Eso están bien para fines ilustrativos, ya que ambos deberían ser casi iguales si representan muestras reales de datos reales. En la vida real, te entrenamos con los datos de entrenamiento, como el archivo lpsa.dat. Luego te Haz predicciones sobre nuevos datos entrantes, que están llaman datos de prueba aunque un nombre mejor sería datos en vivo. Hay son dos parámetros: numIterations y stepSize, además del LabeledPoint. te tendría que entender la lógica y matemáticas del Gradiente Estocástico para saber qué significan, que no explicamos aquí porque están compleja. Básicamente significa cuántas veces puede el algoritmo seguir haciendo bucles para ajustar su estimación, es decir, centrarse en el punto donde el error se acerca lo más posible a cero. Eso están llama convergencia.
val numIterations = 100
val stepSize = 0.00000001
modelo val = LinearRegressionWithSGD.train(parsedData, numIterations, stepSize)
Prueba el modelo
Ahora, para Ve qué tal funciona, recorre el LabelPoint y luego ejecuta el método predict() sobre cada uno, creando un nuevo RDD(doble, doble) de la etiqueta (y o la variable independiente, es decir, el resultado final observado y) y la predicción (la estimación basada en la fórmula de regresión determinada por el algoritmo SDG).
    val valuesAndPreds = parsedData.map { point =>
val prediction = model.predict(point.features)
(point.label, prediction)
}
Calcular error
Un error de 0 significaría que tenemos un modelo perfecto. Como te puede Ve a continuación, el modelo no hace un buen trabajo prediciendo valores hasta que la etiqueta están alta. Para todo el modelo, el error están:
    println("training Mean Squared Error = " + MSE)
training Mean Squared Error = 7.451030996001437
MSE significa la diferencia entre la media ((valor predicho - valor real) ** 2 (al cuadrado)). Cuando el predictivo es casi igual al valor real, entonces MSE está cerca de 0.
    valuesAndPreds.foreach((result) => println(s"predicted label: ${result._1}, actual label: ${result._2}"))
predicted label: -0.4307829, actual label: -6.538896995115336E-8
...
predicted label: 1.446919, actual label: 1.7344923653317994E-7
...
predicted label: 2.6567569, actual label: 3.4906394367410936E-7
predicted label: 1.8484548, actual label: 2.592863859023973E-7
....
predicted label: 2.2975726, actual label: 3.16412860478681E-7
predicted label: 2.7180005, actual label: 3.4164515319254127E-7
predicted label: 2.7942279, actual label: 3.448229999917885E-7
predicted label: 2.8063861, actual label: 3.5506022919177794E-7
predicted label: 2.8124102, actual label: 3.64517218758205E-7
predicted label: 2.8419982, actual label: 3.508992428582512E-7
...
predicted label: 4.029806, actual label: 5.019849314865162E-7
predicted label: 4.1295508, actual label: 5.211902354094908E-7
predicted label: 4.3851468, actual label: 5.732554699437345E-7
predicted label: 4.6844434, actual label: 6.026343831319147E-7
predicted label: 5.477509, actual label: 7.208914981741786E-7
Guía Apache Spark
- La Canalización de Aprendizaje Automático de Apache Spark: Una introducción
- Ejemplo de regresión lineal SGD con Apache Spark
- Clasificador de árbol de decisión de chispa
- Uso de regresión logística, scala y chispa
- Cómo utilizar cuadernos Jupyter con Apache Spark
- Uso de aprendizaje automático en Python y Spark para hacer clasificación
- Cómo escribir UDFs (funciones definidas por el usuario) de Spark en Python
- Ejemplo de Python Spark ML K-Means
- Cómo aplicar el aprendizaje automático a la ciberseguridad
- Apache Spark: Trabajando con Streams
- K-significa agrupación con Apache Spark
- Usando Chispa con Colmena
- Cómo utilizar Apache Spark para Haz predicciones para el mantenimiento preventivo
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.