




Puntos clave: Los datos pueden agruparse en grupos distintos usando Apache Spark y el algoritmo K-Means, como se demuestra en el tutorial. Incluye ejemplos de código y evalúa la efectividad del agrupamiento mediante métricas como la puntuación Silhouette y la suma de errores cuadráticos.
- Los clústeres son formados a partir de puntos de datos usando centroides e hiperplanos.
- Las métricas de evaluación incluyen la puntuación Silhouette y la suma de errores al cuadrado.
En este artículo, mostraremos cómo dividir los datos en grupos distintos, llamados 'grupos', usando Apache Spark y el algoritmo Spark ML K-Means. Este enfoque funciona con cualquier tipo de datos que te quieran dividir según algunas características comunes. Estos datos muestran pacientes médicos, algunos con enfermedad cardíaca y otros sin ella. Ya hemos analizado estos datos usando regresión logística. La clasificación no nos dirá cuáles tienen enfermedad cardíaca (eso es lo que hizo la regresión logística en la publicación anterior), pero te puede deducir lógicamente que un grupo de pacientes están enfermos y otro están no, ya que los indicadores de salud son los datos de entrada.
Comprensión del algoritmo Spark ML K-Means
La clasificación funciona encontrando coordenadas en el espacio n-dimensional que más se acercan a estos datos. Piensa en esto como un plano en el espacio 3D: en un lado son los puntos de datos que pertenecen a un cúmulo, y en el otro lado son en el otro. En este ejemplo, tenemos 12 características de datos (puntos de datos). Tú Verás que el plano tiene las coordenadas que se muestran a continuación. No es un plano como tal, porque son más de tres dimensiones, pero te podrías llamar hiperplano. (Aun así, la imagen mental de un plano está lo suficientemente cerca como para explicar el ejemplo.) A continuación, dividimos los datos en dos grupos, lo que explica por qué tenemos dos conjuntos de coordenadas. Esos son los centroides, o el punto central de cada grupo. Si intentamos dividirlos en un mayor número de grupos, eso se vuelve menos preciso, ya que los datos no están suficientemente separados.
    [5.68235294e+01 5.68627451e-01 3.25490196e+00 1.35803922e+02
 3.00078431e+02 1.47058824e-01 1.18627451e+00 1.45225490e+02
 4.01960784e-01 1.09705882e+00 1.59803922e+00 8.23529412e-01]
[5.29821429e+01 7.44047619e-01 3.12500000e+00 1.28636905e+02
 2.19047619e+02 1.48809524e-01 9.22619048e-01 1.52380952e+02
 2.85714286e-01 1.02142857e+00 1.57738095e+00 5.77380952e-01]
Aquí está el código almacenado como un cuaderno Zeppelin. (La publicación relacionada, en esta Guía, explica el campo de datos y cómo cargar el dataframe de Spark.) Los datos están los mismos, excepto que añadimos una columna de ID del paciente.
    %spark.pyspark

def isSick(x):
    if x in (3,7):
        return 0
    else:
        return 1


import pandas as pd
from pyspark.sql.types import StructType, StructField, NumericType


cols = ('age',
      'sex',
       'chest pain',
       'resting blood pressure',
       'serum cholestoral',
       'fasting blood sugar',
       'resting electrocardiographic results',
       'maximum heart rate achieved',
       'exercise induced angina',
       'ST depression induced by exercise relative to rest',
      'the slope of the peak exercise ST segment',
      'number of major vessels ',
       'thal',
       'last')


data = pd.read_csv('/home/ubuntu/Downloads/heart.csv', delimiter=' ', names=cols)

data['isSick'] = data['thal'].apply(isSick)

rowCount = data['age'].count()
ids = np.arange(1,rowCount+1,1)
data['id'] = ids


df = spark.createDataFrame(data)


from pyspark.ml.feature import VectorAssembler

features =   ('age',
      'sex',
       'chest pain',
       'resting blood pressure',
       'serum cholestoral',
       'fasting blood sugar',
       'resting electrocardiographic results',
       'maximum heart rate achieved',
       'exercise induced angina',
       'ST depression induced by exercise relative to rest',
      'the slope of the peak exercise ST segment',
      'number of major vessels ')


assembler = VectorAssembler(inputCols=features,outputCol="features")

dataset=assembler.transform(df)
dataset.select("features").show(truncate=False)
El código que aparece a continuación está tomado directamente de la documentación de Spark ML con algunas modificaciones, porque solo hay una forma de utilizar el algoritmo. Un par de puntos a tener en cuenta:
- KMeans().setK(2).setSeed(1)—El número 2 están el número de clústeres en los que dividir los datos. Ve que cualquier número mayor que 2 hace que este valor ClusteringEvaluator() caiga por debajo de 0,5, lo que significa que no es una división clara. Otra forma de comprobar el número óptimo de clústeres sería trazar una curva de codo.
- predicciones = model.transform(dataset)—Esto añadirá la columna de predicción al dataframe, para que podamos mostrar qué pacientes cumplen los requisitos para cada categoría.
El resto del código está evidente. El código imprime los centros del clúster para cada división así como la suma de los errores al cuadrado. Eso es una pista de cómo funciona: calcula la distancia de cada punto de datos desde su suposición hasta el centro del clúster, ajusta las suposiciones y luego repite hasta que el número alcanza su mínimo. La distancia de cada punto a este punto central está cuadrada para que la distancia están siempre positiva. El objetivo está tener el menor número posible—la distancia más corta entre todos los puntos de datos.
    %spark.pyspark

from pyspark.ml.evaluation import ClusteringEvaluator
from pyspark.ml.clustering import KMeans

# Trains a k-means model.
kmeans = KMeans().setK(2).setSeed(1)
model = kmeans.fit(dataset)

# Make predictions
predictions = model.transform(dataset)

# Evaluate clustering by computing Silhouette score
evaluator = ClusteringEvaluator()

silhouette = evaluator.evaluate(predictions)
print("Silhouette with squared euclidean distance = " + str(silhouette))


# Evaluate clustering.
cost = model.computeCost(dataset)
print("Within Set Sum of Squared Errors = " + str(cost))

# Shows the result.
print("Cluster Centers: ")
ctr=[]
centers = model.clusterCenters()
for center in centers:
    ctr.append(center)
    print(center)
A continuación, el algoritmo muestra la distancia euclidiana al cuadrado.
- Si este número es negativo, los datos no pueden separarse en absoluto.
- Los valores más cercanos a 1 indican la separación máxima.
- Valores cercanos a cero hacen que los datos apenas puedan separarse.
En este ejemplo, 0,57 no está mal.
    Silhouette with squared euclidean distance = 0.5702065126840549
Within Set Sum of Squared Errors = 548301.9823949672
Cluster Centers:
[5.68235294e+01 5.68627451e-01 3.25490196e+00 1.35803922e+02
 3.00078431e+02 1.47058824e-01 1.18627451e+00 1.45225490e+02
 4.01960784e-01 1.09705882e+00 1.59803922e+00 8.23529412e-01]
[5.29821429e+01 7.44047619e-01 3.12500000e+00 1.28636905e+02
 2.19047619e+02 1.48809524e-01 9.22619048e-01 1.52380952e+02
 2.85714286e-01 1.02142857e+00 1.57738095e+00 5.77380952e-01]
Para Haz que lo visualize fácilmente, convertimos el dataframe de Spark en un dataframe de Pandas para poder utilizar la función z.show de Zeppelin y listar la tabla.
    %spark.pyspark
pandasDF=predictions.toPandas()
centers = pd.DataFrame(ctr,columns=features)
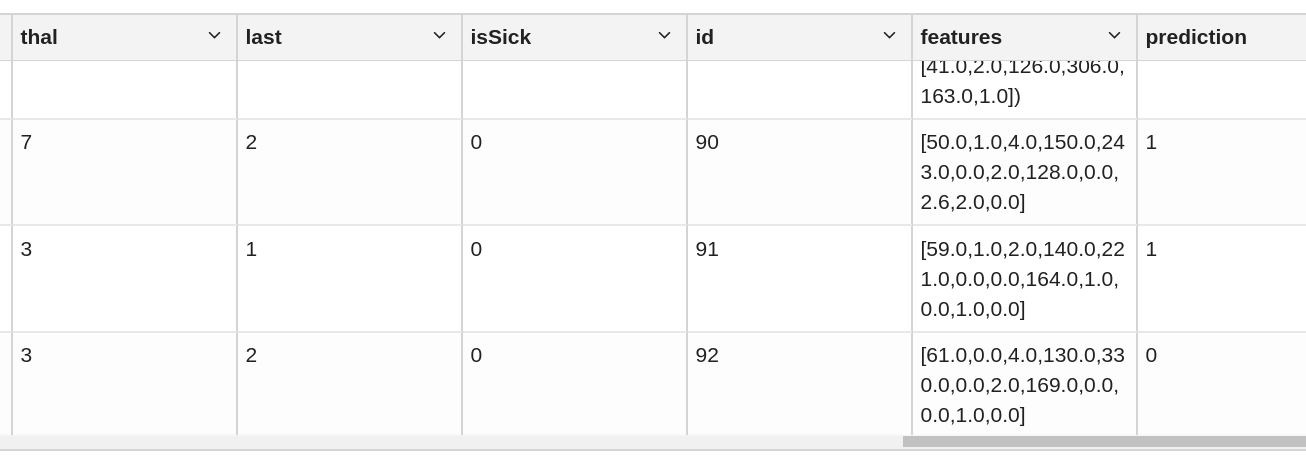
No te puedes graficar estos datos porque un gráfico 3D solo te permite representar tres variables. Así que no podemos mostrar cómo son separados los pacientes cardíacos, pero sí podemos ponerlos en un informe tabular usando z.display() y observar la columna de predicción, que los sitúa en una categoría u otra:
    %spark.pyspark
z.show(pandasDF)
Como podemos Ve, los pacientes 90 y 91 son en el grupo 1. El paciente 92 está en el grupo 0.
Guía Apache Spark
- La Canalización de Aprendizaje Automático de Apache Spark: Una introducción
- Ejemplo de regresión lineal SGD con Apache Spark
- Clasificador de árbol de decisión de chispa
- Uso de regresión logística, scala y chispa
- Cómo utilizar cuadernos Jupyter con Apache Spark
- Uso de aprendizaje automático en Python y Spark para hacer clasificación
- Cómo escribir UDFs (funciones definidas por el usuario) de Spark en Python
- Ejemplo de Python Spark ML K-Means
- Cómo aplicar el aprendizaje automático a la ciberseguridad
- Apache Spark: Trabajando con Streams
- K-significa agrupación con Apache Spark
- Usando Chispa con Colmena
- Cómo utilizar Apache Spark para Haz predicciones para el mantenimiento preventivo
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.