




Puntos clave: El uso de Apache Spark con Hive mejora la velocidad de procesamiento de datos aprovechando las capacidades en memoria de Spark. La guía incluye los requisitos previos de instalación, pasos de configuración e instrucciones para ejecutar trabajos de Hive en Spark.
- Los requisitos previos incluyen instalar Hive y Spark, y establecer variables de entorno.
- Las instrucciones cubren la vinculación de archivos jar, el inicio de Spark y la ejecución de comandos Hive.
Aquí explicamos cómo utilizar Apache Spark con Hive. Eso significa que, en lugar de que Hive almacene datos en Hadoop, los almacena en Spark. La razón por la que la gente utiliza Spark en lugar de Hadoop están que están una base de datos totalmente de memoria. Así que los trabajos de Hive funcionarán mucho más rápido allí. Además, esto hace que los programadores usen una base de datos común si tu empresa usa principalmente Spark. También están posible escribir programas en Spark y utilizar esos para conectar datos a Hive, es decir, ir en la dirección opuesta. Pero ese no están un caso muy probable utiliza, como si te son usando Spark te ya hubiera aceptado la idea de usar RDDs (almacenamiento en memoria de Spark) en lugar de Hadoop. En fin, hablamos aquí de la primera opción.
Requisitos previos e instalación
- te necesitas instala Colmena.
- instala Apache Spark del código fuente (lo explicamos más abajo) para que te pueda tener ya una versión de Spark sin frascos Hive incluidos.
- Establece HIVE_HOME y SPARK_HOME según corresponda.
- instala Hadoop. No lo utiliza excepto el planificador de recursos de Yarn están ahí y los archivos jar. Pero Hadoop no necesita ejecutarse para utiliza Spark con Hive. Sin embargo, si te son ejecutando un clúster Hive o Spark, te puede utiliza Hadoop distribuya archivos jar a los nodos worker copiándolos al HDFS (Hadoop Distributed File System).
Las instrucciones aquí son para Spark 2.2.0 y Hive 2.3.0. Solo tienes que intercambiar los nombres de directorios y archivos jar de abajo para que coincidan con las versiones que te son usas. Ten en cuenta que cuando te buscar los archivos jar en Spark, en varios casos habrá más de una copia. utiliza las de la carpeta dist como se muestra abajo.) Primero te necesitas descargar el código fuente de Spark. te compilarlo así:
./dev/make-distribution.sh --name "hadoop2-without-hive" --tgz "-Pyarn,hadoop-provided,hadoop-2.7,parquet-provided"
Próxima actualización /usr/share/spark/spark-2.2.0/conf/spark-env.sh y añadir:
export SPARK_DIST_CLASSPATH=$(hadoop classpath)
Archivos Link Jar
Ahora Haz enlaces suaves a ciertos archivos de jar de Spark para que Hive pueda encontrarlos:
    ln -s /usr/share/spark/spark-2.2.0/dist/jars/spark-network-common_2.11-2.2.0.jar /usr/local/hive/apache-hive-2.3.0-bin/lib/spark-network-common_2.11-2.2.0.jar
ln -s /usr/share/spark/spark-2.2.0/dist/jars/spark-core_2.11-2.2.0.jar /usr/local/hive/apache-hive-2.3.0-bin/lib/spark-core_2.11-2.2.0.jar
ln -s /usr/share/spark/spark-2.2.0/dist/jars/scala-library-2.11.8.jar /usr/local/hive/apache-hive-2.3.0-bin/lib/scala-library-2.11.8.jar
Comienza Maestro y trabajador de la chispa:
Ahora Comienza Spark.
$SPARK_HOME/sbin/start-all.sh
Haz un directorio que contenga archivos de registro:
mkdir /var/log/spark
Edición $HIVE_HOME/conf/hive-site.xml:
    hive.execution.engine
spark


spark.master
spark://(your IP address):7077


spark.eventLog.enabled
true


spark.eventLog.dir
/var/log/spark


spark.executor.memory
2048m


spark.serializer
org.apache.spark.serializer.KryoSerializer
Run Hive
Ahora ejecuta Hive como se muestra a continuación. Nosotros son ejecutando en modo local en lugar de usar el clúster. Ten en cuenta que le decimos a Hive que registre los errores en la consola para poder Ve si algo falla. También ten en cuenta que utiliza Hive y no vamos directos, la nueva CLI de Hive. Hive quiere que sus usuarios utiliza Beeline, pero no están necesario. (Escribimos sobre cómo utiliza directo aquí.)
hive --hiveconf hive.root.logger=INFO,console
Edita /usr/hadoop/hadoop-2.8.1/etc/hadoop/yarn-site.xml.
    yarn.resourcemanager.scheduler.class
org.apache.hadoop.yarn.server.resourcemanager.scheduler.fair.
FairScheduler
Crea algunos datos
Ahora Crea una tabla e inserta algunos datos. te que esperar un par de segundos después de te escribir un comando para que funcione, ya que usa Spark y Yarn. Recuerda que están diseñado para ejecutarse a través de un clúster.
    create table students (student string, age int);
insert into table students values('Walker', 33);
La pantalla se verá así:
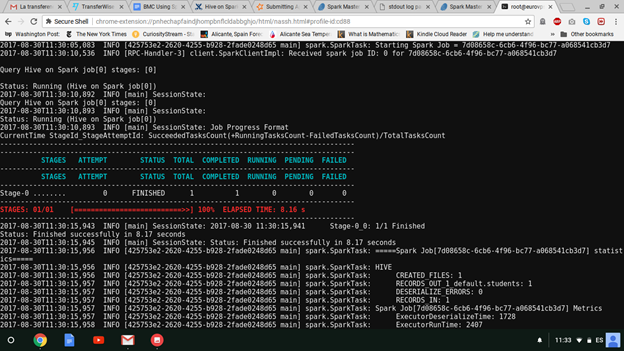
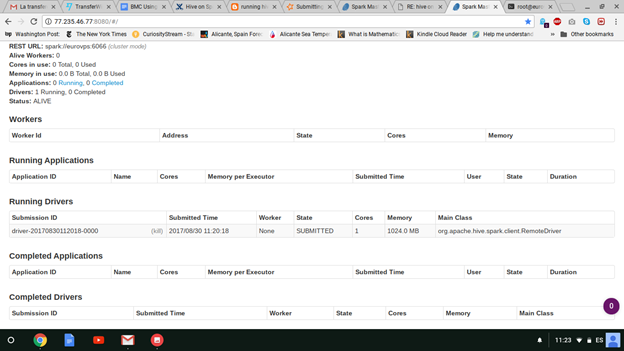
Como tarda un tiempo en Obtén el trabajo, te tener tiempo para abrir la URL de Spark en el puerto 8080 para Ve programas en ejecución. Spark elimina esos datos cuando el trabajo termina, a menos que te ejecute el Servidor de Historial de Trabajos de Spark.
Ahora te son terminado.
Guía Apache Spark
- La Canalización de Aprendizaje Automático de Apache Spark: Una introducción
- Ejemplo de regresión lineal SGD con Apache Spark
- Clasificador de árbol de decisión de chispa
- Uso de regresión logística, scala y chispa
- Cómo utilizar cuadernos Jupyter con Apache Spark
- Uso de aprendizaje automático en Python y Spark para hacer clasificación
- Cómo escribir UDFs (funciones definidas por el usuario) de Spark en Python
- Ejemplo de Python Spark ML K-Means
- Cómo aplicar el aprendizaje automático a la ciberseguridad
- Apache Spark: Trabajando con Streams
- K-significa agrupación con Apache Spark
- Usando Chispa con Colmena
- Cómo utilizar Apache Spark para Haz predicciones para el mantenimiento preventivo
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.