




Puntos clave: Una pipeline de aprendizaje automático Apache Spark agiliza el proceso de transformación de datos, ajuste de modelos y evaluación dentro de un flujo de trabajo unificado, mejorando la claridad y reproducibilidad del código. Este tutorial guía a los usuarios en la conversión de código Spark ML por etapas en un formato estructurado de pipeline para una ejecución eficiente de aprendizaje automático.
- El objeto pipeline consolida operaciones esenciales: transformar, ajustar y evaluar.
- Facilita una mejor mantenibilidad del código mediante órdenes de ejecución automáticas.
Una pipeline de aprendizaje automático Apache Spark están un objeto que encadena operaciones de transformación, evaluación y ajuste en un único flujo de trabajo ejecutable usando org.apache.spark.ml.Pipeline. En lugar de ejecutar cada paso de transformación de datos por separado en un dataframe, te Define todas las etapas una vez y deja que el objeto Pipeline las ejecute en secuencia, haciendo que el código de aprendizaje automático sea más limpio, reproducible y más fácil de llevar a producción.
Este tutorial demuestra el concepto de pipeline de aprendizaje automático de Apache Spark convirtiendo el código ML Spark ya en etapas a formato pipeline. El código existente están explicado en dos entradas del blog: la primera parte y la parte dos. Leer esos primeros están recomendado, ya que te necesitarán para generar los datos utilizados aquí. (Alternativamente, utiliza maintenance_data.csv como datos de prueba y entrenamiento para avanzar .)
El objeto Spark Pipeline están org.apache.spark.ml.{ Pipeline, PipelineModel}.
¿Qué es una pipeline de aprendizaje automático de Apache Spark?
En general, una pipeline de aprendizaje automático describe el proceso de extremo a extremo de escribir código, liberarlo en producción, extraer datos, crear modelos de entrenamiento y ajustar el algoritmo. En Apache Spark específicamente, una pipeline están un objeto que agrupa los pasos de transformación, evaluación y ajuste en un solo objeto: org.apache.spark.ml.Pipeline. Estos pasos juntos son llamados flujo de trabajo.
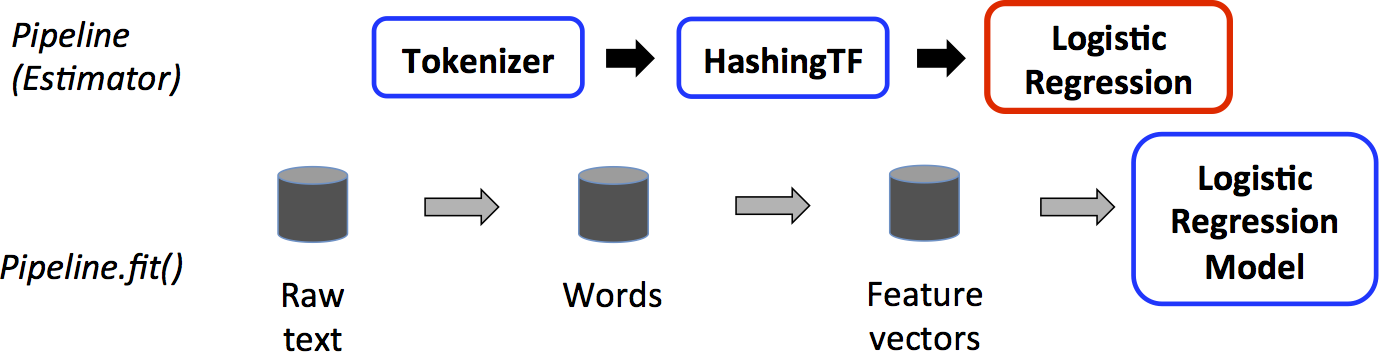
La documentación de Apache Spark ilustra esto con un gráfico: partiendo de un dataframe en bruto , cualquier paso de transformación—junto con el propio algoritmo de ML—son introducidos en el objeto Pipeline, que los ejecuta en la secuencia especificada.
¿Cómo funciona el objeto Spark Pipeline?
El objeto Apache Spark Pipeline ejecuta tres tipos de operaciones en un dataframe:
- Transformar—modifica un dataframe, como añadir columnas de características o etiquetas
- Ajuste—introduce el dataframe en el algoritmo de aprendizaje automático y calcula el resultado, creando el modelo entrenado
- Evaluar—evaluar el rendimiento del modelo
En el gráfico anterior, el dataframe se está creando leyendo datos de Hadoop u otra fuente. Las operaciones de transformación() y ajust() se son realizadas entonces para añadir columnas de características y etiquetas, el formato requerido por el algoritmo de ML de regresión logística. Cada uno de estos pasos discretos está introducido en el objeto pipeline.
El ejemplo de documentación de Spark lo ilustra claramente:
Cada uno de estos tres pasos está gestionado por el objeto pipeline vía val pipeline = new Pipeline().setStages(Array(tokenizer, hashingTF, lr)).
    val tokenizer = new Tokenizer()
  .setInputCol("text")
  .setOutputCol("words")
val hashingTF = new HashingTF()
  .setNumFeatures(1000)
  .setInputCol(tokenizer.getOutputCol)
  .setOutputCol("features")
val lr = new LogisticRegression()
  .setMaxIter(10)
  .setRegParam(0.001)
val pipeline = new Pipeline()
  .setStages(Array(tokenizer, hashingTF, lr))
¿Cómo te conviertes código de aprendizaje automático de Spark en fase en una pipeline?
Para ilustrarlo con un ejemplo práctico, el código que aparece a continuación reescribe los programas de las entradas del blog anteriores—originalmente dos programas separados (Crea model / Haz predictions)—en un solo programa combinado.
Nota: Los ejemplos de código a continuación fueron escritos para Spark 1.x/2.x. Algunas APIs (como com.databricks.spark.csv y SQLContext) han sido reemplazadas en versiones posteriores de Spark, pero los conceptos y la estructura de la tubería siguen siendo válidos en todas las versiones.
Primero, incluye las importaciones necesarias:
    import org.apache.spark.sql.SQLContext
import org.apache.spark.SparkConf
import org.apache.spark.SparkContext
import com.databricks.spark.csv
import org.apache.spark.ml.classification.LogisticRegression
import org.apache.spark.mllib.linalg.{Vector, Vectors}
import org.apache.spark.ml.evaluation.BinaryClassificationEvaluator
import org.apache.spark.ml.feature.{VectorAssembler, StringIndexer}
import org.apache.spark.ml.classification.LogisticRegressionModel
import org.apache.spark.ml.{Pipeline, PipelineModel}
import org.apache.spark.sql.Row
Enfoque antiguo: operaciones preparadas
    val df2 = assembler.transform(df)

val df3 = labelIndexer.fit(df2).transform(df2)

val model = new LogisticRegression().fit(df3)
Nuevo enfoque: Pipeline.setStages()
En lugar de ejecutar operaciones transform() por separado, introduce VectorAssembler(), StringIndexer() y LogisticRegression() en el nuevo Pipeline().setStages(Array(assembler, labelIndexer, lr)). Luego ejecuta pipeline.fit() en el dataframe original . El pipeline ejecuta cada transformación en el orden definido por .setStages().
    var file = "hdfs://localhost:9000/maintenance/maintenance_data.csv";

val sqlContext = new SQLContext(sc)

val df = sqlContext.read.format("com.databricks.spark.csv").option("header", "true").option("inferSchema", "true").option("delimiter",";").load(file)

val featureCols =  Array("lifetime", "pressureInd", "moistureInd", "temperatureInd")

val assembler = new VectorAssembler().setInputCols(featureCols).setOutputCol("features")

val labelIndexer = new StringIndexer().setInputCol("broken").setOutputCol("label")

val lr = new LogisticRegression()

val pipeline = new Pipeline().setStages(Array(assembler, labelIndexer, lr))

val model = pipeline.fit(df)
¿Cómo te Haz predicciones con un Spark PipelineModel adaptado ?
Una vez que la tubería Apache Spark está instalada, hacer predicciones está sencillo. El PipelineModel ajustado ya almacena todas las transformaciones. Lee los datos de prueba (creados en la parte uno de la entrada del blog) y ejecuta transform() sobre ellos. Luego filtra máquinas cuyo valor de predicción de regresión logística están mayor que 0 (es decir, igual a 1) para identificar aquellas que requieren mantenimiento.
    var predictFile = "hdfs://localhost:9000/maintenance/2018.05.30.09.46.55.csv"

val testdf = sqlContext.read.format("com.databricks.spark.csv").option("header", "true").option("inferSchema", "true").option("delimiter",";").load(file)

val predictions =  model.transform(testdf)

predictions.select("team", "provider", "prediction").filter($"prediction" > 0).collect().foreach { case Row(team: String,provider: String, prediction: Double) =>
    println(s"($team, $provider, $prediction) --> team=$team, provider=$provider, prediction=$prediction")
  }
Los resultados son los siguientes:
    (TeamA, Provider4, 1.0) --> team=TeamA, provider=Provider4, prediction=1.0
(TeamC, Provider2, 1.0) --> team=TeamC, provider=Provider2, prediction=1.0
(TeamC, Provider4, 1.0) --> team=TeamC, provider=Provider4, prediction=1.0
(TeamB, Provider1, 1.0) --> team=TeamB, provider=Provider1, prediction=1.0
(TeamC, Provider2, 1.0) --> team=TeamC, provider=Provider2, prediction=1.0
(TeamB, Provider2, 1.0) --> team=TeamB, provider=Provider2, prediction=1.0
(TeamA, Provider2, 1.0) --> team=TeamA, provider=Provider2, prediction=1.0
Preguntas frecuentes sobre los Pipelines de aprendizaje automático Apache Spark
¿Cuál está la diferencia entre una pipeline de Spark ML y ejecutar operaciones por etapas manualmente?
Un enfoque por etapas requiere pasar manualmente los dataframes entre cada transformación y paso de ajuste, aumentando el riesgo de errores de orden y dificultando el mantenimiento del código . Un pipeline de ML de Apache Spark encapsula todos los pasos —incluyendo la ingeniería de características y el ajuste de modelos— en un único objeto Pipeline que los ejecuta automáticamente en la secuencia definida por .setStages().
¿Cuál es la diferencia entre transform() y fit() en una tubería de Apache Spark?
En una tubería de ML Apache Spark, transform() modifica un dataframe añadiendo columnas como vectores de características o etiquetas. fit() introduce el dataframe en el algoritmo de ML y devuelve un modelo entrenado. Ambos pueden definirse como etapas en el objeto Pipeline y ejecutarse juntos mediante pipeline.fit().
¿Qué hace Pipeline.setStages() en Apache Spark?
Pipeline.setStages() define la secuencia ordenada de transformadores y estimadores que ejecutará la canalización. El objeto Pipeline ejecuta cada etapa del array en el orden especificado, pasando el dataframe de salida de cada etapa como entrada a la siguiente.
¿Se puede reutilizar un Spark PipelineModel adaptado para predicciones sobre nuevos datos?
Sí. Una vez entrenado mediante pipeline.fit(), el PipelineModel resultante almacena todos los transformadores ajustados y el estimador entrenado. Llamar a model.transform(testdf) en cualquier nuevo dataframe aplica automáticamente todas las etapas del pipeline; no está necesario redefinir ni volver a ejecutar los pasos de transformación.
¿Qué importaciones son necesarias para utilizar el objeto Spark Pipeline en Scala?
Como mínimo, usar el objeto Apache Spark Pipeline requiere importar org.apache.spark.ml. {Pipeline, PipelineModel}. Dependiendo de los transformadores y estimadores en utiliza, también serán necesarias importaciones adicionales como VectorAssembler, StringIndexer y LogisticRegression desde el paquete org.apache.spark.ml.
Las opiniones expresadas en esta publicación son del autor y no reflejan necesariamente la posición oficial de BMC.
Guía Apache Spark
- La Canalización de Aprendizaje Automático de Apache Spark: Una introducción
- Ejemplo de regresión lineal SGD con Apache Spark
- Clasificador de árbol de decisión de chispa
- Uso de regresión logística, scala y chispa
- Cómo utilizar cuadernos Jupyter con Apache Spark
- Uso de aprendizaje automático en Python y Spark para hacer clasificación
- Cómo escribir UDFs (funciones definidas por el usuario) de Spark en Python
- Ejemplo de Python Spark ML K-Means
- Cómo aplicar el aprendizaje automático a la ciberseguridad
- Apache Spark: Trabajando con Streams
- K-significa agrupación con Apache Spark
- Usando Chispa con Colmena
- Cómo utilizar Apache Spark para Haz predicciones para el mantenimiento preventivo
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.