




Puntos clave: Aplicar el aprendizaje automático mejora la ciberseguridad al mejorar el análisis del tráfico de red, especialmente mediante técnicas como el clúster k-means, que identifica valores atípicos en los registros de routers para una mejor detección de amenazas.
- El aprendizaje automático filtra el ruido en los datos de tráfico de red.
- K-significa agrupar datos de tráfico para un análisis más efectivo.
En este artículo, mostraremos cómo aplicar el aprendizaje automático a la ciberseguridad. son varios casos utiliza, pero este artículo se centrará en analizar los registros de routers.
¿Por qué utilizar el aprendizaje automático con ciberseguridad
Es casi imposible que un analista que mira un gráfico de series temporales del tráfico de red pueda sacar alguna conclusión de lo que son observando. ¿Por qué? La gente no puede Ve más de tres dimensiones. Y demasiadas falsas alertas hacen que los analistas simplemente ignoren parte de lo que ven: demasiado ruido.
Pero el aprendizaje automático permite descubrir, por ejemplo, a hackers criminales que roban datos de tu sistema y los son transmitiendo a su centro de mando y control. Esto es lo que se supone que son los sistemas de detección de intrusiones, pero los hackers utilizan todo tipo de técnicas para evitar ser detectados por los sistemas tradicionales de ciberseguridad. Por ejemplo, podrían transmitir datos robados en pequeños fragmentos y enviar cada uno a una dirección IP diferente, como usuarios de ordenadores domésticos secuestrados, y luego utilizar esos ordenadores secuestrados para enviar esos fragmentos al centro de mando y control hacker.
[vídeo de hélice]
El aprendizaje automático nos ayuda a destilar decenas o cientos de puntos de datos en una o dos métricas. Luego, podemos construir nuestros gráficos y alertas alrededor de ellos. Ahora, esas alertas son significativamente más valiosas.
En este ejemplo ilustraremos un enfoque para analizar el tráfico de red. Utilizamos los registros de router proporcionados por Verizon desde el router tipo Bro. Agruparemos cada registro en uno de siete clústeres y luego analizaremos el tráfico en esos clústeres con menor número de entradas. Eso, por definición, son nuestros valores atípicos.
K-means agrupamiento
Nosotros utiliza el algoritmo de agrupamiento k-media, que separa los datos a lo largo de cualquier número de ejes. (Para más información, Ve ejemplos de agrupamiento k-means con Apache Spark y Python Spark ML K-Means<)
Un científico de datos diría que son estamos enhebrando un hiperplano en un espacio n-dimensional entre los puntos de datos. Como no podemos visualizar esto, piensa en un espacio 3D y luego enhebra un papel entre cada conjunto de puntos de datos de modo que los puntos de un grupo estén en un lado del papel y los del otro grupo son en el otro.
Este es un modelo no supervisado porque no son etiquetas, solo características. Así que no necesitamos entrenar el modelo, ya que no hay nada que predecir. En cambio, son observamos.
El código, explicado
El código está disponible aquí, y los datos aquí. Estos están datos de una herramienta de análisis de red llamada Zeek, anteriormente llamada Bro.
La Universidad de Cincinnati proporciona esta descripción de las columnas en estos datos:
- ts—tiempo; marca de tiempo
- uid—cadena; ID único de conexión
- orig_h—addr; dirección IP del punto final de origen (también conocido como ORIG)
- orig_p—puerto; el puerto TCP/UDP o código ICMP del punto final de origen
- resp_h—addr; dirección IP del endpoint que responde (también conocido como RESP)
- resp_p—puerto; el puerto TCP/UDP o código ICMP del endpoint que responde
- Proto—transport_protoTransport Protocolo de Conexión
- servicio—cadena; protocolo de aplicación detectado dinámicamente, si lo hay
- duración—intervalo; tiempo del último paquete visto hasta tiempo del primer paquete visto
- orig_bytes—conteo; bytes de carga útil originadora, a partir de números de secuencia si TCP
- resp_bytes—conteo; bytes de carga útil de los respondedores, a partir de números de secuencia si TCP
- conn_state—cadena; estado de conexión (tabla Ve conn.log:conn_state)
- local_orig—bool; si conn se originó localmente T; si remotamente F. Si Site::local_nets vacío, siempre sin establecer
- missed_bytes—conteo; número de bytes faltantes en los huecos de contenido
- historia—cadena; historia del estado de conexión (Ve conn.log:tabla de historia)
- orig_pkts—conteo; número de paquetes ORIG
- orig_ip_bytes—conteo; número de bytes IP ORIG (vía IP total_length campo de cabecera)
- resp_pkts—conteo; número de paquetes RESP
- resp_ip_bytes—conteo; número de bytes IP del RESP (a través de IP total_length campo de cabecera)
- tunnel_parents—set; Si se tunela, UID de conexión de los padres encapsulantes
- orig_cc—cuerda; ORIG GeoIP país dode
- resp_cc—cadena; código de país GeoIP de RESP
Primero, cargamos el archivo csv en un dataframe de Spark.
    from pyspark.sql.types import StructType, StructField, FloatType, BooleanType
from pyspark.sql.types import DoubleType, IntegerType, StringType
import pyspark
from pyspark.ml.linalg import Vectors
from pyspark.ml.feature import VectorAssembler
from pyspark.sql.functions import lit
from pyspark.sql.functions import udf, concat

from pyspark import SQLContext

conf = pyspark.SparkConf()

sc = pyspark.SparkContext.getOrCreate(conf=conf)
sqlcontext = SQLContext(sc)

schema = StructType([
    StructField("ts", StringType(),True),
    StructField("uid", StringType(),True),
    StructField("origh", StringType(),True),
    StructField("origp", StringType(),True),
    StructField("resph", StringType(),True),
    StructField("respp", StringType(),True),
    StructField("proto", StringType(),True),
    StructField("service" , StringType(),True),
    StructField("duration", FloatType(),True),
    StructField("origbytes", StringType(),True),
    StructField("respbytes", StringType(),True),
    StructField("connstate", StringType(),True),
    StructField("localorig", StringType(),True),
    StructField("missedbytes", StringType(),True),
    StructField("history", StringType(),True),
    StructField("origpkts", IntegerType(),True),
    StructField("origipbytes", IntegerType(),True),
    StructField("resppkts", IntegerType(),True),
    StructField("respipbytes", IntegerType(),True),
    StructField("tunnelparents", StringType(),True)
              ])


df = sqlcontext.read.csv(path="/home/ubuntu/Documents/forensics/bigger.log", sep="\t", schema=schema)
df2 = df.fillna(0)
A continuación, registramos una función definida por el usuario (UDF). La utilizamos para convertir todos los campos enviados a esta función en enteros porque el aprendizaje automático, en su mayoría, solo funciona con números.
    colsInt = udf(lambda z: toInt(z), IntegerType())

sqlcontext.udf.register("colsInt", colsInt)

def toInt(s):
    if not s:
        return 0
    if isinstance(s, str) == True:
        st = [str(ord(i)) for i in s]
        return(int(''.join(st)))
    else:
        return s
Ahora, Crea algunas columnas adicionales que son las columnas que hemos seleccionado para alimentar nuestro modelo. Para cada una de ellas, llamaremos al colsInt() UDF para convertirlas en números.
te podría variar la elección de columnas según las hipótesis que te quieran seguir. Por ejemplo, a continuación analizamos los puertos y el tráfico, así como el protocolo.
- Puede que haya otras métricas en ese registro que podríamos añadir o eliminar.
- Probablemente deberíamos dejar fuera la dirección IP de destino en el modelo debido a la capacidad del hacker para ocultar su destino real.
- Podríamos eliminar el protocolo UDP ya que SFTP (que están TCP) sería el protocolo que utilizarían para transmitirlo.
- O podríamos incluir la hora del día en la zona horaria local para aislar los eventos fuera de horario.
Todo depende del tipo de actividad en la que te quieras centrarte.
Ten en cuenta que cada una de las sentencias .withColumn() Crea un nuevo dataframe. Esto se está a que los dataframes de Spark son inmutables.
    a = df2.withColumn( 'iorigp',colsInt('origp'))
c = a.withColumn( 'irespp',colsInt('respp'))
d = c.withColumn( 'iproto',colsInt('proto'))
e = d.withColumn('iorigh',colsInt('origh'))
f = e.withColumn( 'iorigbytes',colsInt( 'origbytes'))
g = f.withColumn( 'irespbytes',colsInt('respbytes'))
h = g.withColumn(  'iorigpkts',colsInt( 'origpkts'))
i = h.withColumn( 'iorigipbytes',colsInt('origipbytes'))

columns =  ['iorigp','irespp','iproto', 'iorigbytes','irespbytes','iorigpkts','iorigipbytes']
El siguiente paso añade una columna a nuestro dataframe llamada features. Esta están una tupla de las columnas que hemos seleccionado. El algoritmo K-means esperará que haya una columna features.
    vecAssembler = VectorAssembler(inputCols=columns, outputCol="features")
router = vecAssembler.transform(i)
Aquí utilizamos el algoritmo K-means. Una ventaja de Apache Spark están que sus algoritmos de aprendizaje automático son fáciles de usar. No requieren el reprocesamiento y remodelación que requieren otros frameworks, y funcionan con dataframes Spark, así que podríamos trabajar con conjuntos de datos mucho mayores. (Pandas no escala como los dataframes de Spark.)
    from pyspark.ml.clustering import KMeans
from pyspark.ml.evaluation import ClusteringEvaluator


kmeans = KMeans().setK(7).setSeed(1)
model = kmeans.fit(router)

predictions = model.transform(router)

p = predictions.groupby('prediction').count()
q = p.toPandas()
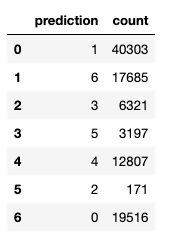
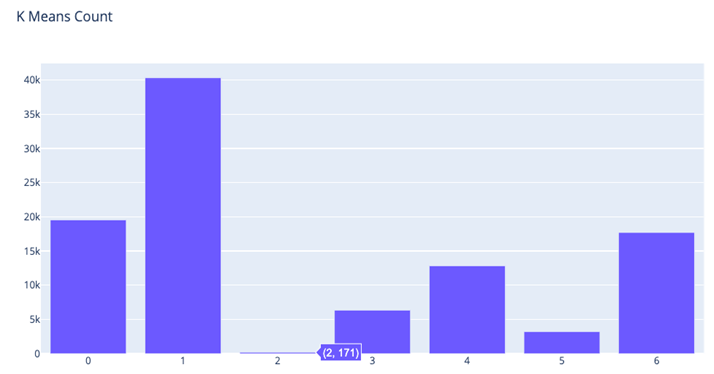
Hemos agrupado las observaciones en 7 clústeres. El clúster 0 tiene 40.303 registros de routers, pero el clúster 2 solo tiene 171. Claramente, son casos atípicos, así que aquí están donde centramos nuestro análisis de ciberseguridad.
Podemos graficar eso como un gráfico de barras para mostrar mejor cómo están agrupados los datos.
    from plotly.offline import plot

import pandas as pd


import plotly.graph_objects as go
fig = go.Figure(
    data=[go.Bar(x=q['prediction'],y=q['count'])],
    layout_title_text="K Means Count"
)
fig.show()
Plotly usa JavaScript para Crea ventanas emergentes que te den más información sobre dónde tú colocas el cursor. Lo hemos colocado en el punto (predicción=2, conteo=121).
Así que, vamos a Haz un nuevo dataframe solo con esos registros del clúster 2. (En realidad es el índice de fila 5 en el dataframe, así que no confundas esos dos conceptos.)
suspect = predictions.filter("prediction == 2")
Aquí convertimos la salida a Pandas, simplemente porque el cuaderno Jupyter muestra esos datos con más claridad que los dataframes, donde tiende a cortar columnas anchas, dificultándolas de leer.
x = suspect.select('ts','uid','origh','resph').toPandas()
te puede Ve la misma dirección IP mostrada más de una vez, lo que probablemente están un buen lugar para un análisis más profundo. Mira y Ve qué máquina están y a quién se conecta.
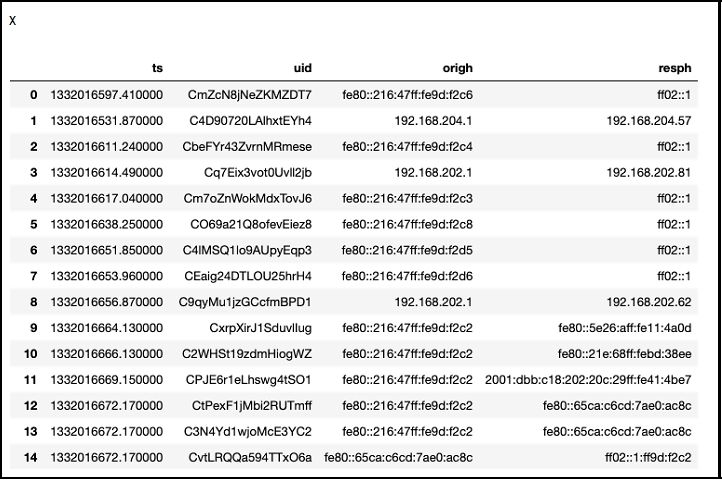
Así, tus analistas pueden revisar los registros en tus aplicaciones, cortafuegos, etc., para Ve qué pasa con esas direcciones IP. (Ten en cuenta que algunas son en formato IPv6.)
Guía Apache Spark
- La Canalización de Aprendizaje Automático de Apache Spark: Una introducción
- Ejemplo de regresión lineal SGD con Apache Spark
- Clasificador de árbol de decisión de chispa
- Uso de regresión logística, scala y chispa
- Cómo utilizar cuadernos Jupyter con Apache Spark
- Uso de aprendizaje automático en Python y Spark para hacer clasificación
- Cómo escribir UDFs (funciones definidas por el usuario) de Spark en Python
- Ejemplo de Python Spark ML K-Means
- Cómo aplicar el aprendizaje automático a la ciberseguridad
- Apache Spark: Trabajando con Streams
- K-significa agrupación con Apache Spark
- Usando Chispa con Colmena
- Cómo utilizar Apache Spark para Haz predicciones para el mantenimiento preventivo
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.