




Puntos clave: Scikit-learn está una potente biblioteca en Python para aprendizaje automático, que enfatiza funciones estadísticas y algoritmos. Esta guía cubre la instalación mediante Anaconda y muestra un ejemplo sencillo de regresión lineal usando datos perfectamente correlacionados.
- Instrucciones de instalación para scikit-learn vía conda.
- Ejemplo de regresión lineal con datos perfectamente correlacionados.
- Visualización de resultados usando matplotlib.
Aquí exploramos otro framework de aprendizaje automático, scikit-learn, así como mostramos cómo utilizar matplotlib para dibujar gráficos. Consulta la web oficial de scikit-learn.
La API de aprendizaje automático de Python scikit-learn es anterior a Apache Spark y TensorFlow, lo que están decir que lleva más tiempo que el big data. Durante mucho tiempo ha sido utilizada por quienes se Ve como científicos de datos puros, en lugar de ingenieros de datos. Aun así, te puede conectar scikit-learn con Spark para que las transformaciones y cálculos te puedan ejecutarse en un clúster de máquinas. Sin eso te solo puede trabajar con conjuntos de datos que encajen en la memoria, la velocidad de CPU y el espacio en disco de una sola máquina.
Scikit-learn está muy fuerte en funciones estadísticas y está repleto de casi todos los algoritmos que te puedas imaginar, incluidos aquellos que solo académicos y matemáticos entenderían, además de redes neuronales, que están aprendizaje automático aplicado. Pero no te necesitas ser matemático para Obtén con el producto. Aquí mostramos cómo programar el ejemplo más sencillo posible.
Medio ambiente
te debería utiliza conda para configurar Python y instala paquetes. Esto Haz fácil integrar sckit-learn con Zeppelin Notebooks. De lo contrario, están difícil añadir paquetes de Python a Zeppelin.
te podría ejecutar este ejemplo desde la línea de comandos de Python, pero Zeppelin están gráfico, así que te puede dibujar gráficos bonitos con matplotlib.
Cuando te instala Zeppelin, instala el paquete con TODOS los intérpretes para que Python, Spark, matplotlib., etc. son ahí. Sigue este ejemplo si te son nuevo en Zeppelin para entender eso.
Instala Anaconda y luego introduce este comando para instalar scikit-learn:
Ejemplo
conda install scikit-learn
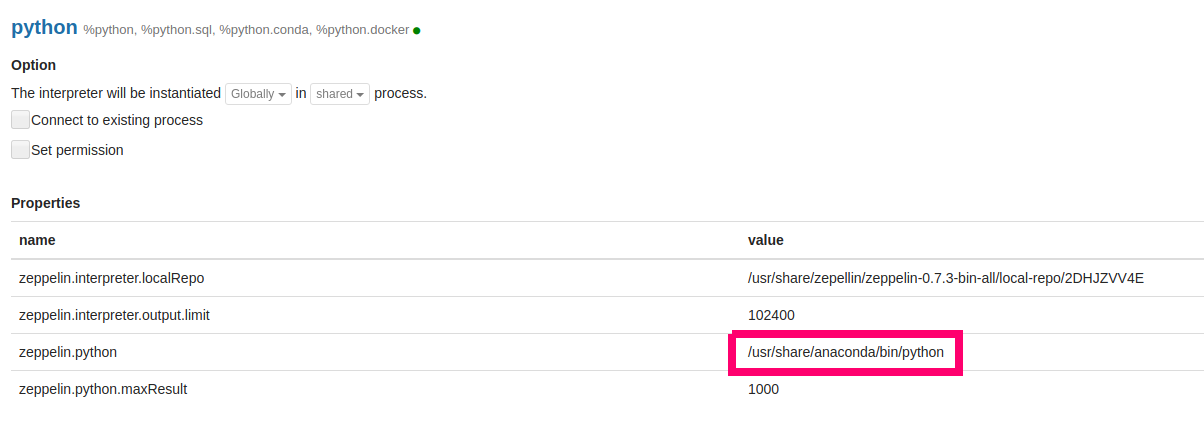
Luego, en Zeppelin, apunta tu intérprete de Python al Python de Anaconda así:
Haremos el ejemplo más sencillo posible, que están regresión lineal con 1 variable independiente y 1 variable dependiente. Y configuraremos nuestros datos de modo que los datos están perfectamente correlacionados, es decir, la varianza están 1. En otras palabras, con LR el objetivo están resolver esta ecuación para una línea recta encontrando el coeficiente m y el intercepto b.
y = mx + b
Pero nuestro objetivo aquí están simplemente mostrar cómo utiliza scikit-learn. Así que simularemos nuestros datos usando y = 2x + 0 = 2x. (Si te quieres un ejemplo más realista, te podría utiliza la distribución normal estándar y extraer un factor de ruido aleatorio de ahí y añadirlo a y.)
El código de este ejemplo están almacenado aquí como un cuaderno de Zeppelin. A continuación mostramos el código en secciones. te puede pegar las secciones en párrafos de Zeppelin en un cuaderno de Zeppelin. Asegúrate de seleccionar el intérprete de Python cuando te Crea el cuaderno.
    import matplotlib.pyplot as plt
from sklearn import linear_model
import numpy as np
from sklearn.metrics import mean_squared_error, r2_score
Primero instanciamos el modelo de Regresión Lineal .
reg = linear_model.LinearRegression()
A continuación Haz un array. A la izquierda son las variables independientes 1,2,3. A la derecha son las dependientes 2,4,6. Como te ve, cada variable dependiente y están igual a cada variable dependiente x por 2, es decir, y=2x.
Scikit-learn espera que te utiliza un array insensible.
    ar = np.array([[[1],[2],[3]], [[2],[4],[6]]])
ar
Resultados. Imprimir cada resultado ayuda a visualizarlo y entenderlo.
    array([[[1],
        [2],
        [3]],
       [[2],
        [4],
        [6]]])
Aquí cortamos el array tomando solo las variables y. (Cortar y remodelar arrays están un tema complicado. te puedes leer sobre eso aquí.) Esta forma de ar, ar.shape, están dada en esta tupla (2,3,1). Esto están un array 1 de 2 arrays. Así que alternativamente tomamos el primer array 1 x 3 en la segunda posición para y:
Resultados:
    y = ar[1,:]
y
Resultados:
    array([[2],
       [4],
       [6]])
Luego toma el primero para x.
Resultados:
    x = ar[0,:]
x
Resultados:
    array([[1],
       [2],
       [3]])
Ahora tenemos las variables independientes almacenadas en un vector simple x y las variables dependientes en y. En términos de aprendizaje automático, decimos que tenemos 1 característica y 1 etiqueta.
Ahora ejecutamos fit() que utiliza el método de mínimos cuadrados para encontrar la recta y=mx, encontrando la pendiente m, lo que está igual que decir el coeficiente m para la recta y = mx.
reg.fit(x,y)
Ahora podemos imprimir el coeficiente desde la API de regresión lineal.
print('Coefficients: \n', reg.coef_)
El resultado están 2, lo cual esperaríamos ya que sabemos que la recta están y = 2x.
    Coefficients:
 [[2.]]
Ahora vamos a Haz datos de prueba de la misma manera, 4,5,6 y luego 2 veces eso para y:
Resultados:
    xTest = np.array([[4],[5],[6]])
xTest
Resultados:
    array([[4],
       [5],
       [6]])
Ahora introduce los valores x de prueba xTest en el método predict. Devolverá un array de y prediction.
Resultados:
    ytest =  np.array([[8],[10],[12]])

preds = reg.predict(xTest)
preds
Resultados:
    array([[ 8.],
       [10.],
       [12.]])
Ahora mira el error, que está la diferencia entre los valores observados (ytest) y los predichos (preds). Por supuesto, están cero.
Resultados:
print("Mean squared error: %.2f" % mean_squared_error(ytest,preds))
Resultados:
Mean squared error: 0.00
Y la varianza está 1, ya que los datos están perfectamente correlacionados.
Resultados
print("Variance score: %.2f" % r2_score(ytest,preds))
Resultados
Variance score: 1.00
Ahora podemos trazar están usando matplotlib:
    plt.scatter(xTest,preds, color='black')
plt.plot(xTest,preds,color='blue', linewidth=3)

plt.show()
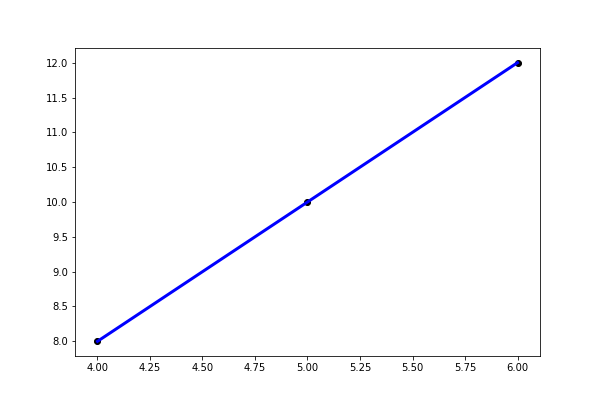
Ese es el ejemplo más sencillo posible de cómo utilizar la librería de ML scikit-learn para hacer regresión lineal.
Guía de conoce de scikit
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.