




Puntos clave: Conoce a utilizar el Clasificador de Árbol de Decisión de Spark para predecir el consumo de combustible basándose en las características del automóvil, utilizando Scala y datos de la Universidad de Pensilvania. El tutorial incluye una visión general completa de la clasificación del árbol de decisión junto con ejemplos prácticos de Scala.
- Ilustra la aplicación de Apache Spark ML para la clasificación por árboles de decisión.
- Proporciona código Scala y pasos de procesamiento de datos para una mejor comprensión.
Aquí explicamos cómo utilizar el Clasificador de Árbol de Decisión con Apache Spark ML (aprendizaje automático). Utilizamos datos de la Universidad de Pensilvania aquí y aquí. Escribimos la solución en código Scala y guiamos al lector por cada línea del código.
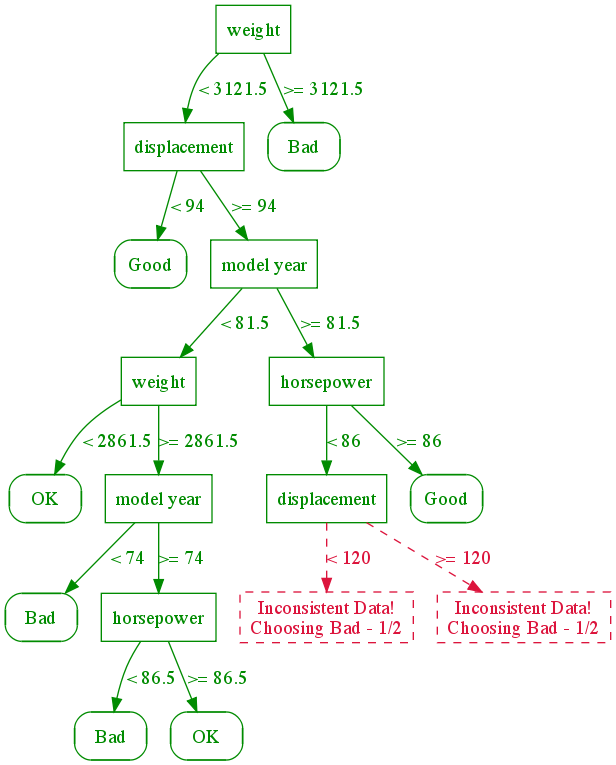
No te molestes en leer la parte de matemáticas de las notas de clase de Penn, a menos que te sepas mucha matemática. Ese conocimiento no es necesario aquí. En su lugar, este gráfico a continuación te da todo lo que tú necesitas para entender la idea básica:
El objetivo están mirar los automóviles y predecir el consumo de gasolina. El kilometraje está malo (0), bueno (1) o aceptable (2) según el número de cilindros, la cilindrada, la potencia, el peso, el tiempo de aceleración hasta 60 mph, el año modelo y el continente de origen. Debajo del gráfico están los datos en formato de hoja de cálculo con texto, y debajo, el texto se está convertido en números.
El gráfico de abajo describe cómo funciona el árbol de decisión. Primero te mirar el peso. Si están pesado, el kilometraje están malo. Si no están pesado y la cilindrada del motor están alta, entonces te que mirar el año modelo. te seguir dividiendo este problema hasta te Obtén un punto en el que lógicamente no tenga sentido seguir adelante. Obviamente, si un coche pesa mucho, enseguida te decir que su kilometraje será malo.
Aquí están los datos con encabezados de columna.
| mpg | Cilindros | Desplazamiento | Caballos de potencia | Peso | Aceleración | Año modelo | Fabricante |
|---|---|---|---|---|---|---|---|
| Malo | 8 | 350 | 150 | 4699 | 14.5 | 74 | América |
| Malo | 8 | 400 | 170 | 4746 | 12 | 71 | América |
| Malo | 8 | 400 | 175 | 4385 | 12 | 72 | América |
| Malo | 6 | 250 | 72 | 3158 | 19.5 | 75 | América |
| Vale | 4 | 121 | 98 | 2945 | 14.5 | 75 | Asia |
| Vale | 6 | 232 | 90 | 3085 | 17.6 | 76 | América |
| Vale | 4 | 120 | 97 | 2506 | 14.5 | 72 | Europa |
Y aquí está convertido a formato numérico para que podamos utilizarlo con el algoritmo de aprendizaje automático. Descarga esos datos de aquí y guárdalos en tu disco o ponlos en Hadoop.
0 8 350 150 4699 14,5 74 0
0 8 400 170 4746 12 71 0
0 8 400 175 4385 12 72 0
0 6 250 72 3158 19.5 75 0
0 8 304 150 3892 12,5 72 0
0 8 350 145 4440 14 75 0
0 6 250 105 3897 18,5 75 0
0 6 163 133 3410 15.8 78 1
0 8 260 110 4060 19 77 0
1 4 97 75 2171 16 75 2
1 4 97 78 1940 14.5 77 1
1 4 98 83 2219 16.5 74 1
2 4 79 70 2074 19.5 71 1
2 4 91 68 1970 17.6 82 2
2 4 89 71 1925 14 79 1
2 4 83 61 2003 19 74 2
Código Scala
Ejecuta Spark-shell o Crea un cuaderno Zeppelin y pega el código de abajo.
Resultados:
    import org.apache.spark.mllib.tree.DecisionTree
import org.apache.spark.mllib.tree.model.DecisionTreeModel
import org.apache.spark.mllib.util.MLUtils
import org.apache.spark.mllib.linalg.Vectors
import org.apache.spark.mllib.regression.LabeledPoint
import org.apache.spark.mllib.feature.Normalizer
// read the data file and split it by spaces
val data = sc.textFile("/home/walker/mileage.txt").map( l => l.split("\\s+"))
// convert every string to doubles
var dbl = data.map (m => m.map(l => l.toDouble))
// Here we create a Dense Vector and LabeledPoint. A Dense Vector is a
// special kind of Vector than the scala regular Vector. So use Vectors, with an “s”
// at the end. The values must be doubles. A Dense Vector cannot handle
// blank values. If we had that those, we would use a Sparse Vector.
//
// The LabeledPoint is an object with the label and features. The label
// is 0, 1, 2 or gas mileage and the features are the weight, year, etc.
val parsedData = dbl.map { y =>
val c = Vectors.dense(y(1),y(2),y(3),y(4),y(5),y(6),y(7))
LabeledPoint(y(0), c)
}.cache()
// numClasses means number of classifications. In this case it is
// 0, 1, or 2
val numClasses = 3
// Here we say that the 6th feature is categorical with 3 possible values.
// It can be American, European, or Asian.
// The rest of the values are continuous, meaning just numbers and not discrete
// values.
val categoricalFeaturesInfo = Map(6 -> 3)
val impurity = "gini"
val maxDepth = 9
val maxBins = 7
// Now feed the data into the model.
val model = DecisionTree.trainClassifier(parsedData, numClasses, categoricalFeaturesInfo , impurity, maxDepth, maxBins)
// Print out the results
println("Learned classification tree model:\n" + model.toDebugString)
Clasificador DecisionTreeModel de profundidad 5 con 21 nodos
Aquí dice que tenemos 21 nodos (extremos inferiores) y 5 niveles de decisiones que tomar. Por ejemplo, si la característica 3 (peso) [Comienza numeración en 0.] están <= 2930, entonces tenemos que mirar la característica 1 (desplazamiento, etc.) para derivar nuestra predicción de 0, 1, 2.
    If (feature 3 <= 2930.0)
If (feature 1 <= 91.0)
Predict: 2.0
Else (feature 1 > 91.0)
If (feature 5 <= 81.0)
If (feature 2 <= 105.0)
Predict: 1.0
Else (feature 2 > 105.0)
If (feature 0 <= 4.0)
Predict: 0.0
Else (feature 0 > 4.0)
Predict: 1.0
Else (feature 5 > 81.0)
If (feature 2 <= 85.0)
Predict: 0.0
Else (feature 2 > 85.0)
Predict: 2.0
Else (feature 3 > 2930.0)
If (feature 3 <= 3193.0)
If (feature 2 <= 85.0)
Predict: 0.0
Else (feature 2 > 85.0)
If (feature 2 <= 105.0)
If (feature 0 <= 4.0)
Predict: 1.0
Else (feature 0 > 4.0)
Predict: 0.0
Else (feature 2 > 105.0)
Predict: 0.0
Else (feature 3 > 3193.0)
Predict: 0.0
Luego guardaríamos este modelo y utilizaríamos el método predict() para adelantar un vehículo en particular y predecir qué kilometraje tendrá.
te quizá hayas notado que este tipo de modelo están similar a la regresión logística. Pero utiliza árboles de decisión (son hay varios tipos) cuando queremos manejar muchos datos, ya que están menos costosos computacionalmente. En otras palabras, funciona más rápido y consume menos memoria.
También hay que tener en cuenta que la clase de Penn usó la herramienta de programación de matemáticas y estadísticas de Matlab. Pero ese tipo de herramientas no pueden funcionar con big data. No escalan como Apache Spark a millones o más de decisiones.
Guía Apache Spark
- La Canalización de Aprendizaje Automático de Apache Spark: Una introducción
- Ejemplo de regresión lineal SGD con Apache Spark
- Clasificador de árbol de decisión de chispa
- Uso de regresión logística, scala y chispa
- Cómo utilizar cuadernos Jupyter con Apache Spark
- Uso de aprendizaje automático en Python y Spark para hacer clasificación
- Cómo escribir UDFs (funciones definidas por el usuario) de Spark en Python
- Ejemplo de Python Spark ML K-Means
- Cómo aplicar el aprendizaje automático a la ciberseguridad
- Apache Spark: Trabajando con Streams
- K-significa agrupación con Apache Spark
- Usando Chispa con Colmena
- Cómo utilizar Apache Spark para Haz predicciones para el mantenimiento preventivo
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.