




Puntos clave: Integrar Jupyter Notebooks con Apache Spark permite a los desarrolladores aprovechar el análisis de big data utilizando herramientas conocidas. Esta guía ilustra cómo configurar Jupyter y PySpark para el análisis de datos, destacando procedimientos de instalación y configuración para un rendimiento óptimo.
- Jupyter soporta múltiples lenguajes de programación, mejorando la flexibilidad en el análisis de datos.
- PySpark permite a los usuarios de Python interactuar sin problemas con las funcionalidades de Apache Spark.
Visualiza e interactúa con datos usando Apache Spark y Jupyter Notebook
Apache Spark están un motor de análisis rápido y de código abierto desarrollado en UC Berkeley para big data y aprendizaje automático. Spark utiliza caché en memoria y ejecución optimizada de consultas para ofrecer una solución rápida y eficiente de procesamiento de big data. Además, Spark puede soportar fácilmente múltiples cargas de trabajo que van desde procesamiento por lotes, consultas interactivas, análisis en tiempo real hasta aprendizaje automático y procesamiento de grafos. Todas estas capacidades han llevado a Spark a convertirse en una herramienta líder en análisis de datos. Desde la perspectiva del desarrollador, una de las mejores cualidades de Spark están su soporte para múltiples lenguajes. A diferencia de muchas otras plataformas con opciones limitadas o que requieren que los usuarios conoce un lenguaje específico de cada plataforma, Spark soporta todos los lenguajes líderes de análisis de datos como R, SQL, Python, Scala y Java. Spark ofrece a los desarrolladores la libertad de seleccionar un lenguaje que son familiarizados y utilizar fácilmente cualquier herramienta o servicio compatible con ese lenguaje al desarrollar. Al considerar Python, Jupyter Notebooks están una de las herramientas más populares disponibles para un desarrollador. Pero, ¿cómo podemos Haz que un Jupyter Notebook funcione con Apache Spark? En esta publicación, Ve cómo utilizar Jupyter, Spark y PySpark para Crea una instalación de Apache Spark que pueda realizar análisis de datos a través de tu interfaz familiar de Jupyter Notebook.
Cómo funcionan los Cuadernos Jupyter
Jupyter es un entorno computacional interactivo gestionado por Jupyter Project y distribuido bajo la licencia BSB modificada. Un Cuaderno están un documento compartible que combina tanto entradas como salidas en un solo archivo. Estos cuadernos pueden consistir en:
- Código
- Ecuaciones matemáticas
- Texto narrativo
- Visualizaciones
- Modelado estadístico
- Otros medios ricos
La ventaja de un portátil están que permite a los desarrolladores desarrollar, visualizar, analizar y añadir cualquier tipo de información para Crea un único archivo fácil de entender y compartir. Este enfoque está muy útil en análisis de datos, ya que permite a los usuarios incluir toda la información relacionada con los datos dentro de un cuaderno específico. Jupyter soporta más de 40 lenguajes de programación y está disponible en dos formatos:
- El clásico cuaderno Jupyter
- El JupyterLab
JupyterLab es la interfaz de notebook de próxima generación que mejora aún más la funcionalidad de Jupyter para Crea una herramienta más flexible que puede usarse para apoyar cualquier flujo de trabajo, desde ciencia de datos hasta aprendizaje automático. Jupyter también soporta herramientas de Big Data como Apache Spark para necesidades de análisis de datos. (Lee nuestra introducción completa a Jupyter Notebooks.)
Cómo conectar Jupyter con Apache Spark
Si te necesitas utiliza Spark en Jupyter Notebook, Scala están el lenguaje ideal para interactuar con Apache Spark tal como están escrito en Scala. Sin embargo, la mayoría de los desarrolladores prefieren utiliza un lenguaje con el que son familiarizados, como Python. Jupyter soporta tanto Scala como Python. Sin embargo, Python están la opción más flexible en la mayoría de los casos debido a su robustez, facilidad de utiliza y la disponibilidad de librerías como pandas, scikit-learn y TensorFlow. Aunque proyectos como almond permiten a los usuarios añadir Scala a Jupyter, en esta publicación nos centraremos en Python. (Ve por qué Python es el lenguaje preferido para el aprendizaje automático.)
PySpark para Apache Spark y Python
Python se conecta con Apache Spark a través de PySpark. Permite a los usuarios escribir aplicaciones Spark usando la API de Python y proporciona la capacidad de interactuar con los Conjuntos de Datos Distribuidos Resilientes (RDDs) en Apache Spark. PySpark permite que Python se conecte con objetos JVM usando la biblioteca Py4J. Además, PySpark soporta la mayoría de las funciones de Apache Spark como SQL de Spark, DataFrame, MLib, Spark Core y Streaming.
Configuración de PySpark con Jupyter y Apache Spark
Antes de configurar PySpark, necesitamos tener instalados Jupyter y Apache Spark. En esta sección, cubriremos los procedimientos sencillos de instalación para usar Spark en Jupyter Notebook. te puede seguir esta guía de Jupyter Notebooks para Análisis de Datos para instrucciones detalladas sobre cómo instalar Jupiter, y te puede seguir la documentación oficial de Spark para configurarlo en su entorno local.
Instalación de Spark
te necesitarán Java, Scala y Git como requisitos previos para instalar Spark. Podemos instala usando el siguiente comando:
sudo apt install default-jdk scala git -y
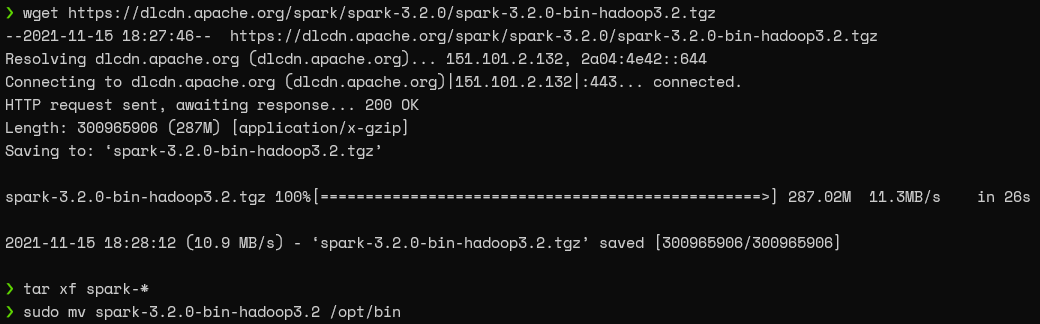
Luego, Obtén la última versión de Apache Spark, extrae el contenido y muévelo a un directorio separado usando los siguientes comandos.
    wget https://dlcdn.apache.org/spark/spark-3.2.0/spark-3.2.0-bin-hadoop3.2.tgz
tar xf spark-*
sudo mv spark-3.2.0-bin-hadoop3.2 /opt/spark
RESULTADO
Luego podemos configurar las variables ambientales añadiéndolas al archivo de configuración del shell (Ex: .bashrc / .zshrc) como se muestra a continuación.
    export SPARK_HOME=/opt/spark
export PATH=$PATH:$SPARK_HOME/bin:$SPARK_HOME/sbin
export PYSPARK_PYTHON=/usr/bin/python3
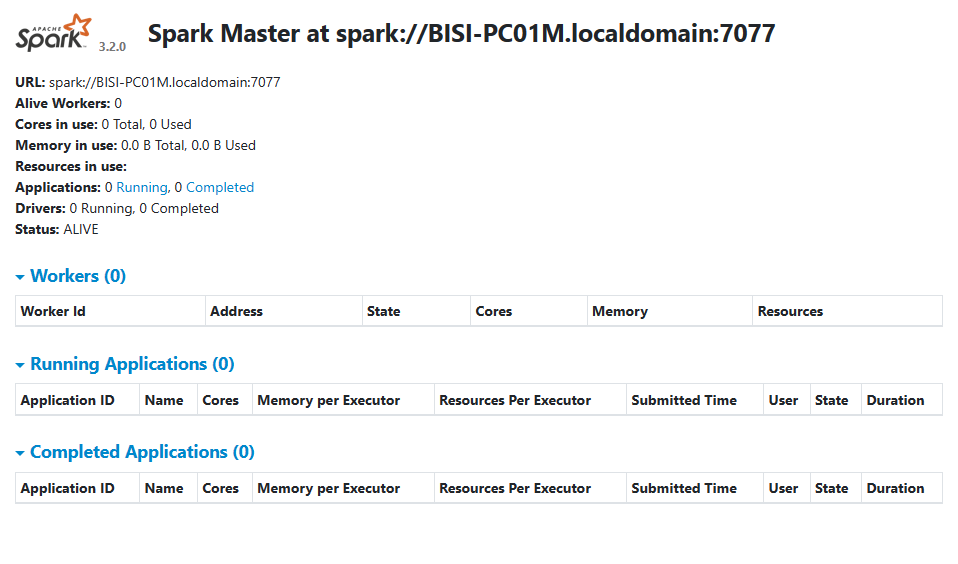
La variable SPARK_HOME indica la instalación de Apache Spark, y PATH añade Apache Spark (SPARK_HOME) a las rutas del sistema. Después de eso, la variable PYSPARK_PYTHON apunta a la instalación en Python. Finalmente, ejecuta el comando start-master.sh a Comienza Apache Spark y te podrás confirmar la instalación exitosa visitando http://localhost:8080/ Command
Interfaz web
Instalación de Jupyter
Instalar Jupyter están un proceso sencillo y directo. Puede instalarse directamente a través del gestor de paquetes Python usando el siguiente comando:
pip install notebook
Instalación de PySpark
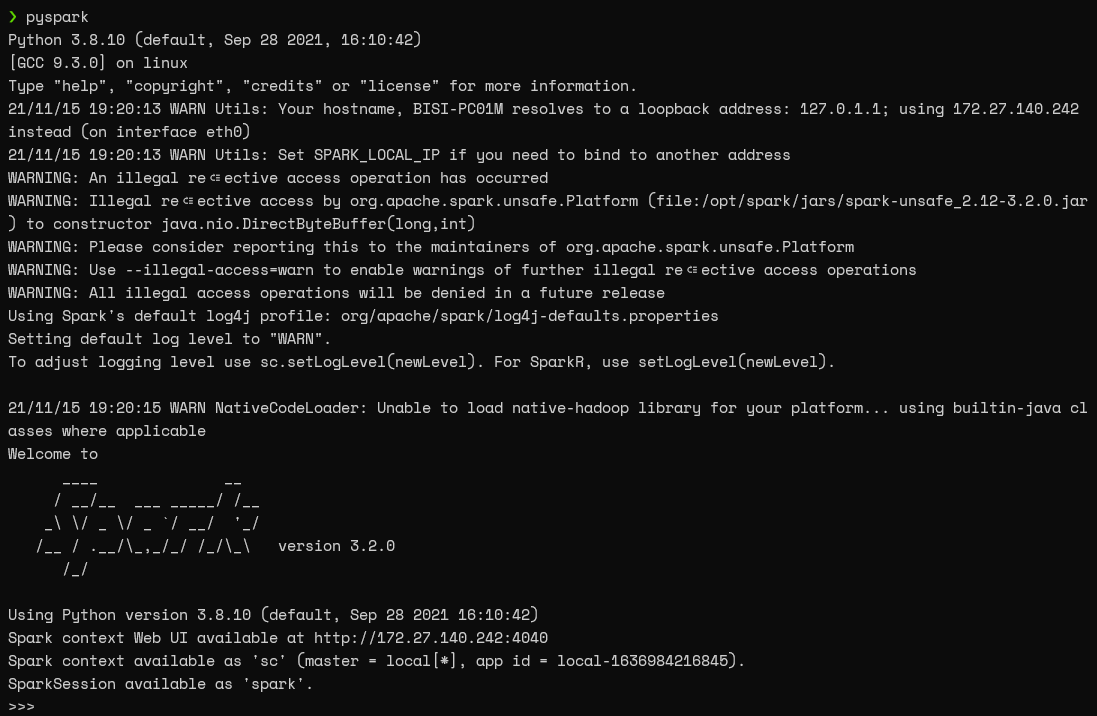
No es necesario instala PySpark por separado, ya que viene incluido con Spark. Sin embargo, también te la opción de instalar PySpark y las dependencias adicionales como Spark SQL o Pandas para Spark como una instalación separada a través del gestor de paquetes Python. te puede lanzar PySpark directamente ejecutando el siguiente comando en el terminal.
pyspark
RESULTADO:
Cómo integrar PySpark con Jupyter Notebook
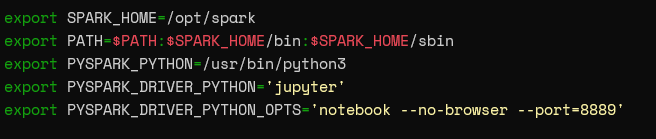
El único requisito para Obtén la referencia de Jupyter Notebook PySpark están añadir las siguientes variables ambientales en tu archivo .bashrc o .zshrc, que apunta a PySpark a Jupyter.
    export PYSPARK_DRIVER_PYTHON='jupyter'
export PYSPARK_DRIVER_PYTHON_OPTS='notebook --no-browser --port=8889'
La PYSPARK_DRIVER_PYTHON apunta a Júpiter, mientras que la PYSPARK_DRIVER_PYTHON_OPTS define las opciones a usar al iniciar el portátil. En este caso, indica la opción de no usar navegador y el puerto 8889 para la interfaz web. Con las variables anteriores, tu archivo shell debería ahora incluir las cinco variables de entorno necesarias para alimentar esta solución.
Ahora, podemos lanzar directamente una instancia de Jupyter Notebook ejecutando el comando pyspark en el terminal.
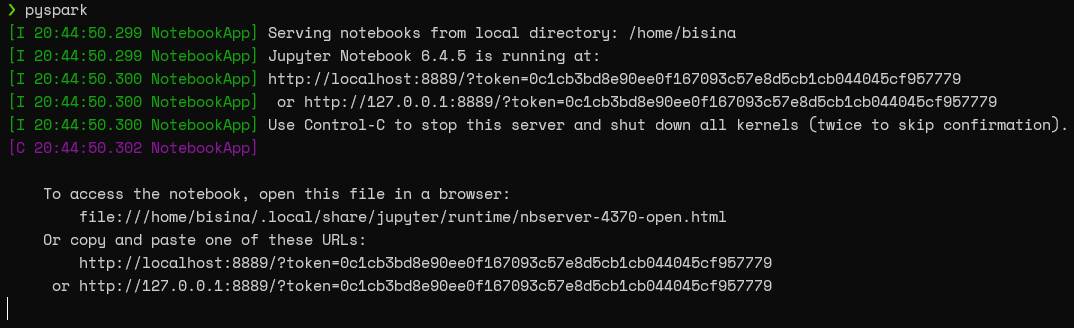
Nota importante: Siempre Haz refrescar el entorno del terminal; de lo contrario, las variables de entorno añadidas no serán reconocidas. Ahora visita la URL proporcionada y te son listo para interactuar con Spark a través del Jupyter Notebook.
Probando el Jupyter Notebook con PySpark
Como ya hemos configurado la integración, lo único que queda están comprobar si todo está funcionando bien. Así que, ejecutemos un script simple en Python que use librerías Pyspark y Crea un data frame con un conjunto de datos de prueba. Crea el data frame:
    # Import Libraries
from pyspark.sql.types import StructType, StructField, FloatType, BooleanType
from pyspark.sql.types import DoubleType, IntegerType, StringType
import pyspark
from pyspark import SQLContext

# Setup the Configuration
conf = pyspark.SparkConf()

spark_context = SparkSession.builder.config(conf=conf).getOrCreate()
sqlcontext = SQLContext(sc)

# Setup the Schema
schema = StructType([
StructField("User ID", IntegerType(),True),
StructField("Username", StringType(),True),
StructField("Browser", StringType(),True),
StructField("OS", StringType(),True),
])

# Add Data
data = ([(1580, "Barry", "FireFox", "Windows" ),
(5820, "Sam", "MS Edge", "Linux"),
(2340, "Harry", "Vivaldi", "Windows"),
(7860, "Albert", "Chrome", "Windows"),
(1123, "May", "Safari", "macOS")
])

# Setup the Data Frame
user_data_df = sqlcontext.createDataFrame(data,schema=schema)
Imprimir el marco de datos:
user_data_df.show()
RESULTADO:

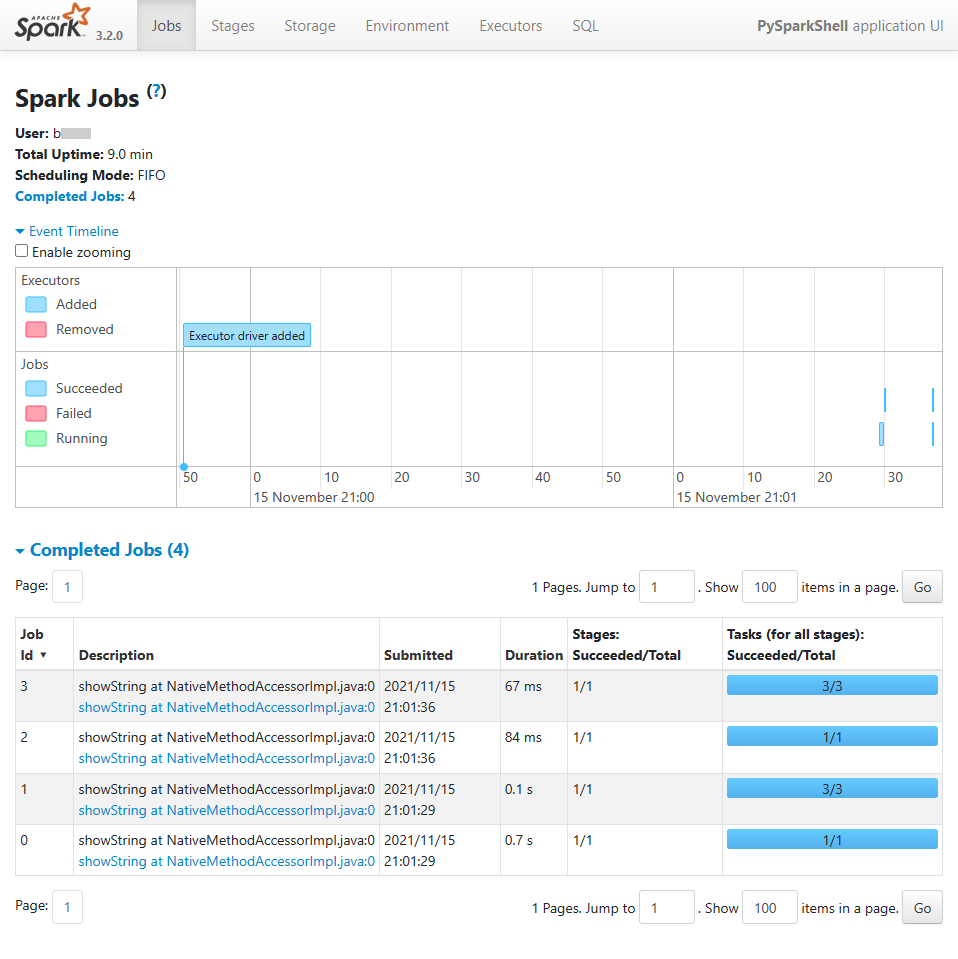
Si miramos la interfaz web de PySpark, que está accesible a través del puerto 4040, podemos Ve los detalles del trabajo de ejecución del script como se muestra a continuación.
El poder de usar Spark y Jupyter Notebook
Apache Spark están una potente herramienta de análisis de datos y big data. PySpark permite a los usuarios interactuar con Apache Spark sin tener que conoce otro lenguaje como Scala. La combinación de Jupyter Notebooks y Spark ofrece a los desarrolladores un entorno de desarrollo potente y familiar, aprovechando al mismo tiempo el poder de Apache Spark.
Guía Apache Spark
- La Canalización de Aprendizaje Automático de Apache Spark: Una introducción
- Ejemplo de regresión lineal SGD con Apache Spark
- Clasificador de árbol de decisión de chispa
- Uso de regresión logística, scala y chispa
- Cómo utilizar cuadernos Jupyter con Apache Spark
- Uso de aprendizaje automático en Python y Spark para hacer clasificación
- Cómo escribir UDFs (funciones definidas por el usuario) de Spark en Python
- Ejemplo de Python Spark ML K-Means
- Cómo aplicar el aprendizaje automático a la ciberseguridad
- Apache Spark: Trabajando con Streams
- K-significa agrupación con Apache Spark
- Usando Chispa con Colmena
- Cómo utilizar Apache Spark para Haz predicciones para el mantenimiento preventivo
Estas publicaciones son mías y no representan necesariamente la posición, estrategias u opinión de BMC.